PIVOT·UNPIVOT과 정규 표현식
목차
SQLD 2과목의 「PIVOT 절과 UNPIVOT 절」, 「정규 표현식」 항목을 정리합니다. 행 값을 열로 펼치는 PIVOT의 문법과 암묵적 GROUP BY, IN 목록과 열 이름, PIVOT과 같은 결과를 내는 CASE·DECODE + GROUP BY, 열을 행으로 세우는 UNPIVOT과 NULL 처리, LIKE와 정규 표현식의 차이, 정규 표현식 기호, REGEXP_LIKE·REGEXP_SUBSTR·REGEXP_INSTR·REGEXP_REPLACE·REGEXP_COUNT, 마침표·탐욕 일치·대소문자 함정, SQL Server와의 차이를 쇼핑몰 예시로 살펴본 뒤 기출 유형 연습 문제 5개로 확인합니다.
앞 글 「계층형 질의와 셀프 조인」에서 한 테이블 안의 위아래 관계를 펼쳐 보았습니다. 이번 글은 두 부분입니다. 앞부분은 세로로 긴 집계 결과를 가로 표로 바꾸는 PIVOT과 그 반대인 UNPIVOT이고, 뒷부분은 LIKE보다 세밀하게 문자열 패턴을 찾는 정규 표현식입니다. PIVOT 예시는 「집합 연산자와 ROLLUP·CUBE·GROUPING SETS」의 등급 × 가격대 판매금액을 가로로 펼친 것이고, 정규 표현식 예시는 고객의 이메일·휴대폰번호와 쿠폰명 세 값입니다. 연습 문제는 실제 시험과 같은 유형으로 새로 만든 문제입니다.
1. PIVOT과 UNPIVOT 한눈에 보기
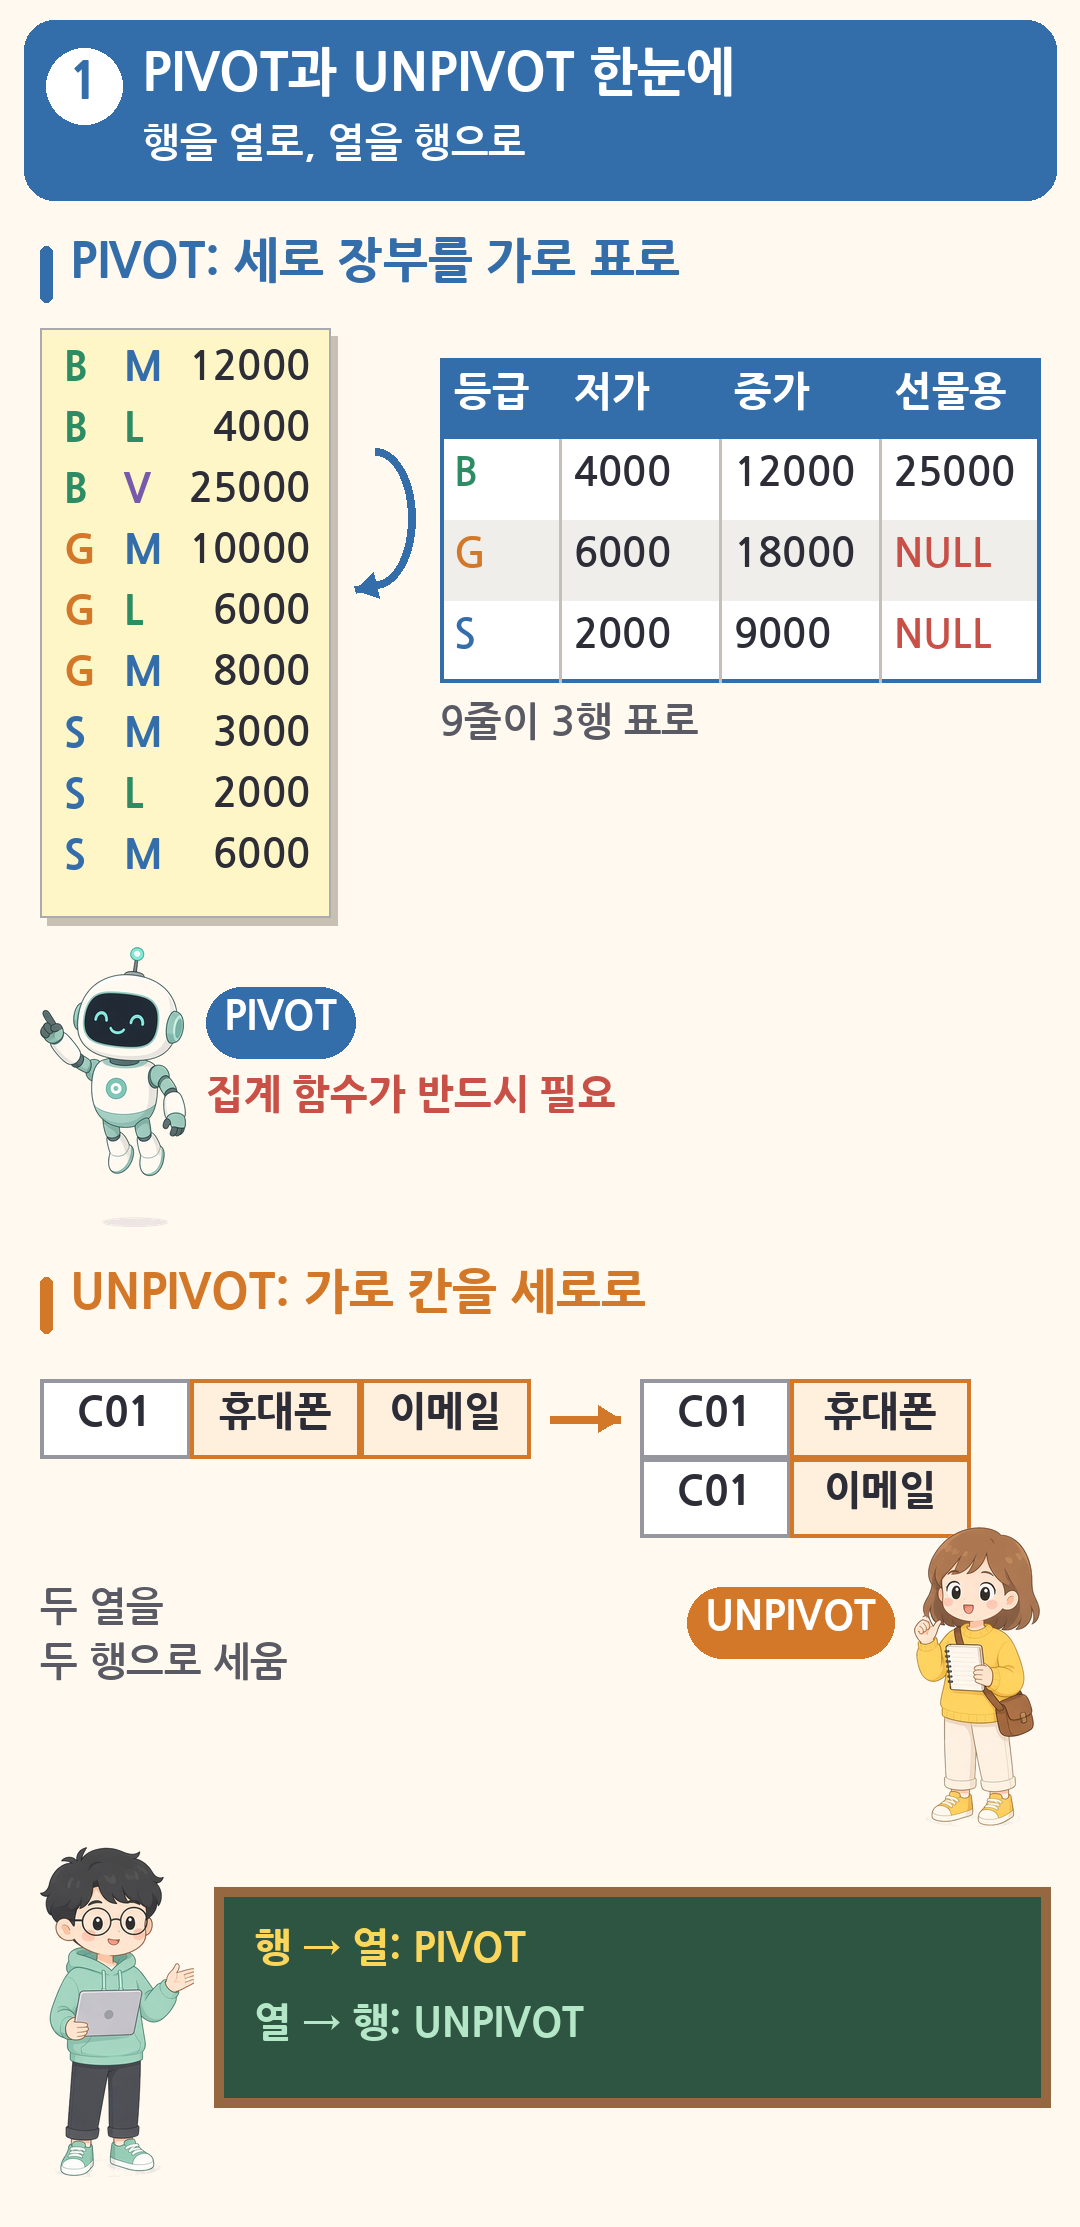
| 절 | 하는 일 | 집계 함수 |
|---|---|---|
| PIVOT | 행 값(가격대코드 L, M, V)을 열로 펼침. 세로 장부를 가로 표로 | 반드시 필요 |
| UNPIVOT | 여러 열(휴대폰번호, 이메일)을 행으로 세움. 가로 표를 세로 장부로 | 쓰지 않음 |
둘 다 FROM 절의 테이블이나 인라인 뷰 뒤에 붙습니다. PIVOT 예시의 재료는 주문상품에 주문, 고객, 상품을 잇고 가격대를 비등가 조인한 판매 내역입니다. 주문상품 11줄을 등급·주문·가격대별로 묶어 더하면 다음 9행이 되고, PIVOT은 이 금액을 등급별로 다시 더해 가로로 펼칩니다.
| 등급·주문 | 가격대코드 | 금액 |
|---|---|---|
| B 5004 | M | 12000 |
| B 5007 | L | 4000 |
| B 5007 | V | 25000 |
| G 5001 | M | 10000 |
| G 5003 | L | 6000 |
| G 5006 | M | 8000 |
| S 5002 | M | 3000 |
| S 5005 | L | 2000 |
| S 5005 | M | 6000 |
고가(H) 구간의 귤은 팔리지 않았으므로 H 행은 없습니다.
2. PIVOT 문법과 결과
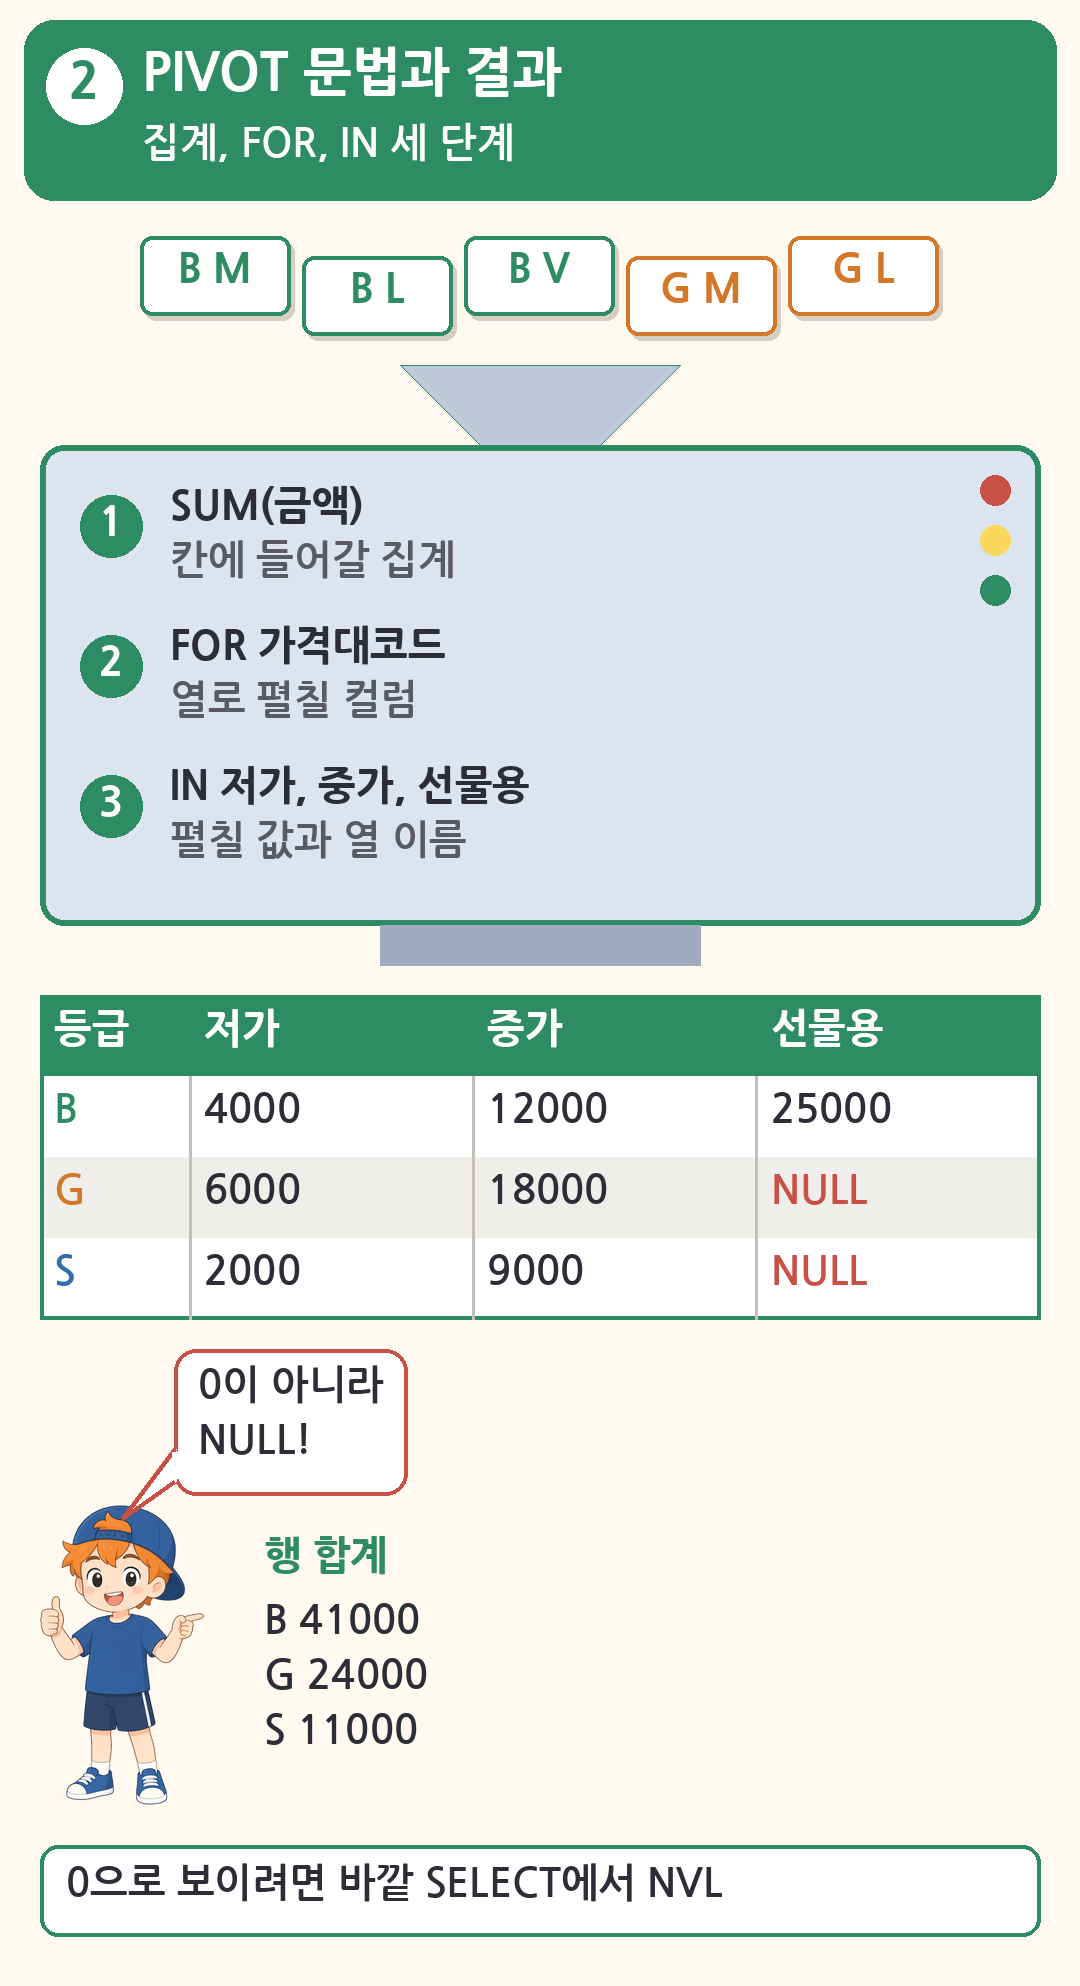
등급별로 가격대 금액을 열로 펼칩니다.
SELECT *
  FROM (SELECT c.등급코드, g.가격대코드, oi.주문수량 * oi.주문단가 AS 금액
          FROM 주문상품 oi
          JOIN 주문 o   ON oi.주문번호 = o.주문번호
          JOIN 고객 c   ON o.고객번호 = c.고객번호
          JOIN 상품 p   ON oi.상품번호 = p.상품번호
          JOIN 가격대 g ON p.판매가 BETWEEN g.최저가 AND g.최고가)
 PIVOT (SUM(금액)                                          -- ① 칸에 들어갈 집계
        FOR 가격대코드                                      -- ② 열로 펼칠 컬럼
        IN ('L' AS 저가, 'M' AS 중가, 'V' AS 선물용))       -- ③ 펼칠 값과 열 이름
ORDER BY 등급코드;| 등급코드 | 저가 | 중가 | 선물용 |
|---|---|---|---|
| B | 4000 | 12000 | 25000 |
| G | 6000 | 18000 | NULL |
| S | 2000 | 9000 | NULL |
- 행 합계는 B 41000, G 24000, S 11000으로 「집합 연산자와 ROLLUP·CUBE·GROUPING SETS」의 등급별 소계와 같습니다.
- 판매가 없는 칸은 0이 아니라 NULL입니다. 0으로 보이려면 바깥 SELECT에서 NVL을 씌웁니다.
- IN 목록에
'H' AS 고가를 더하면 고가 열이 생기지만 세 등급 모두 NULL입니다.
| 구성 | 규칙 |
|---|---|
| 집계 함수 | 반드시 하나 이상. 집계 없이 쓰면 오류(ORA-56902) |
| FOR 컬럼 | 열로 펼칠 기준 컬럼 |
| IN 목록 | 상수 값을 직접 나열하고 별칭을 붙일 수 있음. 일반 PIVOT에서는 서브쿼리를 쓸 수 없음 |
| IN 별칭 | 붙이면 별칭이 열 이름, 안 붙이면 값 그대로('L', 'M')가 열 이름 |
| IN 목록에 없는 값 | 결과에서 버려짐. IN ('L' AS 저가)만 쓰면 저가 열 하나만 나옴 |
| 그 밖의 컬럼 | PIVOT에 쓰이지 않은 컬럼은 모두 암묵적 GROUP BY 기준 |
3. 암묵적 GROUP BY와 CASE·DECODE 방식
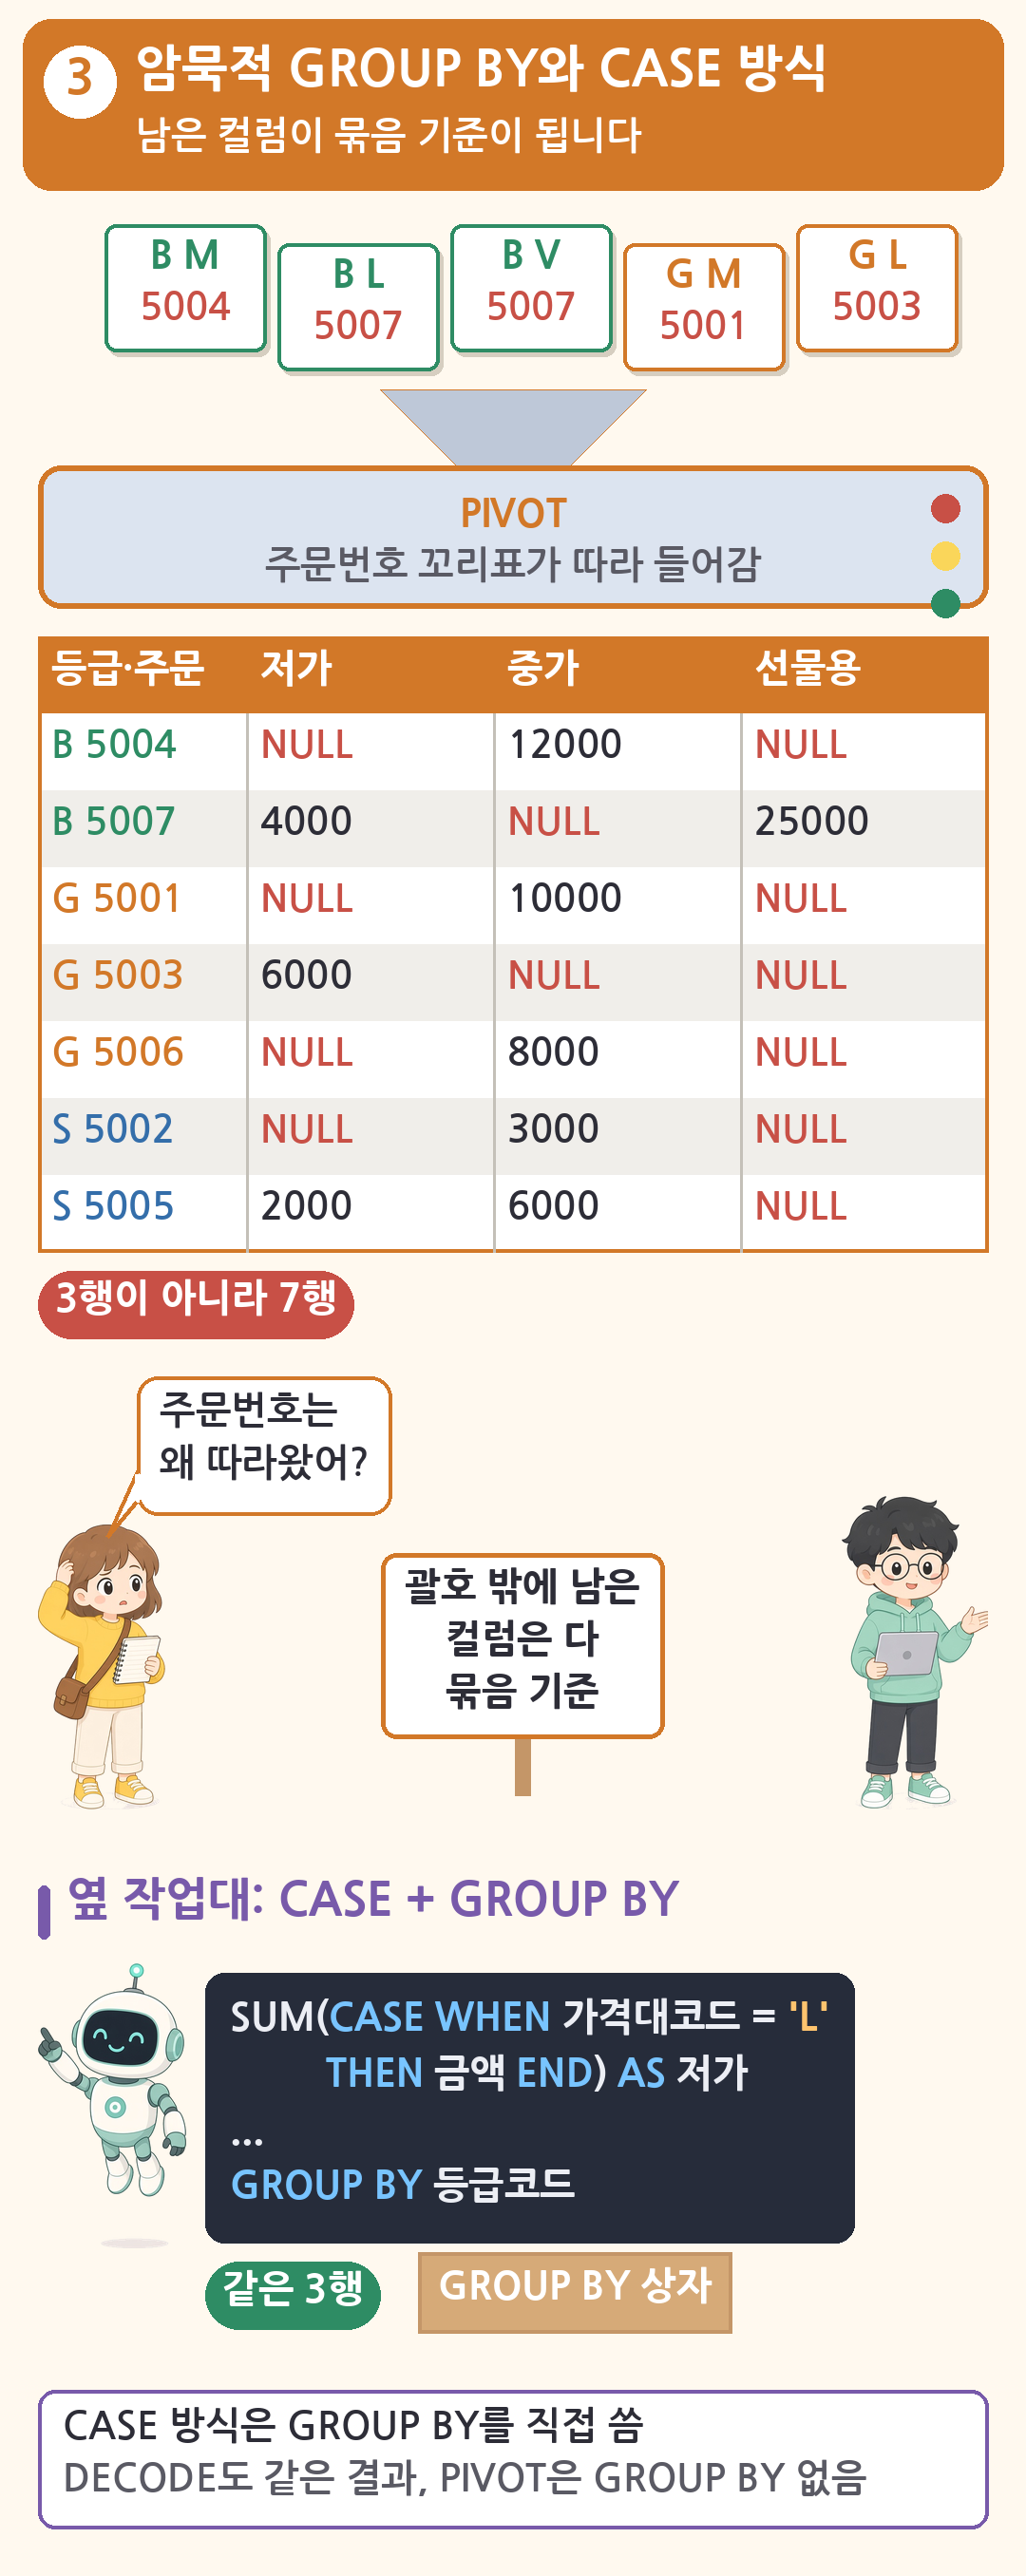
원본에 컬럼이 더 있으면 행이 늘어납니다
PIVOT은 집계 함수와 FOR 컬럼에 쓰이지 않은 나머지 컬럼으로 알아서 GROUP BY를 합니다. 원본 인라인 뷰에 주문번호를 하나 더 넣으면 그룹 기준이 (등급코드, 주문번호)가 되어 3행이 7행으로 늘어납니다.
| 등급·주문 | 저가 | 중가 | 선물용 |
|---|---|---|---|
| B 5004 | NULL | 12000 | NULL |
| B 5007 | 4000 | NULL | 25000 |
| G 5001 | NULL | 10000 | NULL |
| G 5003 | 6000 | NULL | NULL |
| G 5006 | NULL | 8000 | NULL |
| S 5002 | NULL | 3000 | NULL |
| S 5005 | 2000 | 6000 | NULL |
- 그래서 PIVOT은 보통 필요한 컬럼만 고른 인라인 뷰에 겁니다. 테이블에 바로 걸면 남은 컬럼 전부가 그룹 기준이 됩니다.
- 예를 들어
SELECT * FROM 상품 PIVOT (COUNT(*) FOR 판매가 IN (4000 AS 사천원))은 상품번호, 상품명별로 묶여 6행이 나오고, 사천원 열은 P20과 P50만 1입니다.
집계 함수를 여러 개 쓰기
PIVOT (SUM(금액) AS 금액, COUNT(*) AS 건수 FOR 가격대코드 IN ('M' AS 중가))처럼 집계 함수를 둘 이상 쓰면 열 이름은 「IN 별칭_집계 별칭」이 됩니다. 집계 함수가 둘 이상이면 집계 별칭을 붙입니다.
| 등급코드 | 중가_금액 | 중가_건수 |
|---|---|---|
| B | 12000 | 2 |
| G | 18000 | 3 |
| S | 9000 | 2 |
PIVOT 이전 방식: CASE·DECODE + GROUP BY
SELECT 등급코드,
       SUM(CASE WHEN 가격대코드 = 'L' THEN 금액 END) AS 저가,
       SUM(CASE WHEN 가격대코드 = 'M' THEN 금액 END) AS 중가,
       SUM(CASE WHEN 가격대코드 = 'V' THEN 금액 END) AS 선물용
  FROM (2장의 인라인 뷰)
GROUP BY 등급코드;- 결과는 2장의 PIVOT과 똑같습니다.
SUM(DECODE(가격대코드, 'L', 금액))도 같고,NVL(SUM(...), 0)을 씌우면 NULL 칸이 0이 됩니다. - 「SQL 함수, 문자·숫자·날짜·NULL 함수와 CASE」의 CASE·DECODE와 「GROUP BY와 HAVING, 집계 함수와 NULL」의 GROUP BY를 합친 모양입니다. 시험에서는 「PIVOT과 같은 결과를 내는 SQL 고르기」로 나옵니다. CASE 방식은 GROUP BY를 직접 써야 하고, PIVOT은 GROUP BY를 쓰지 않는다는 점이 다릅니다.
4. UNPIVOT과 NULL
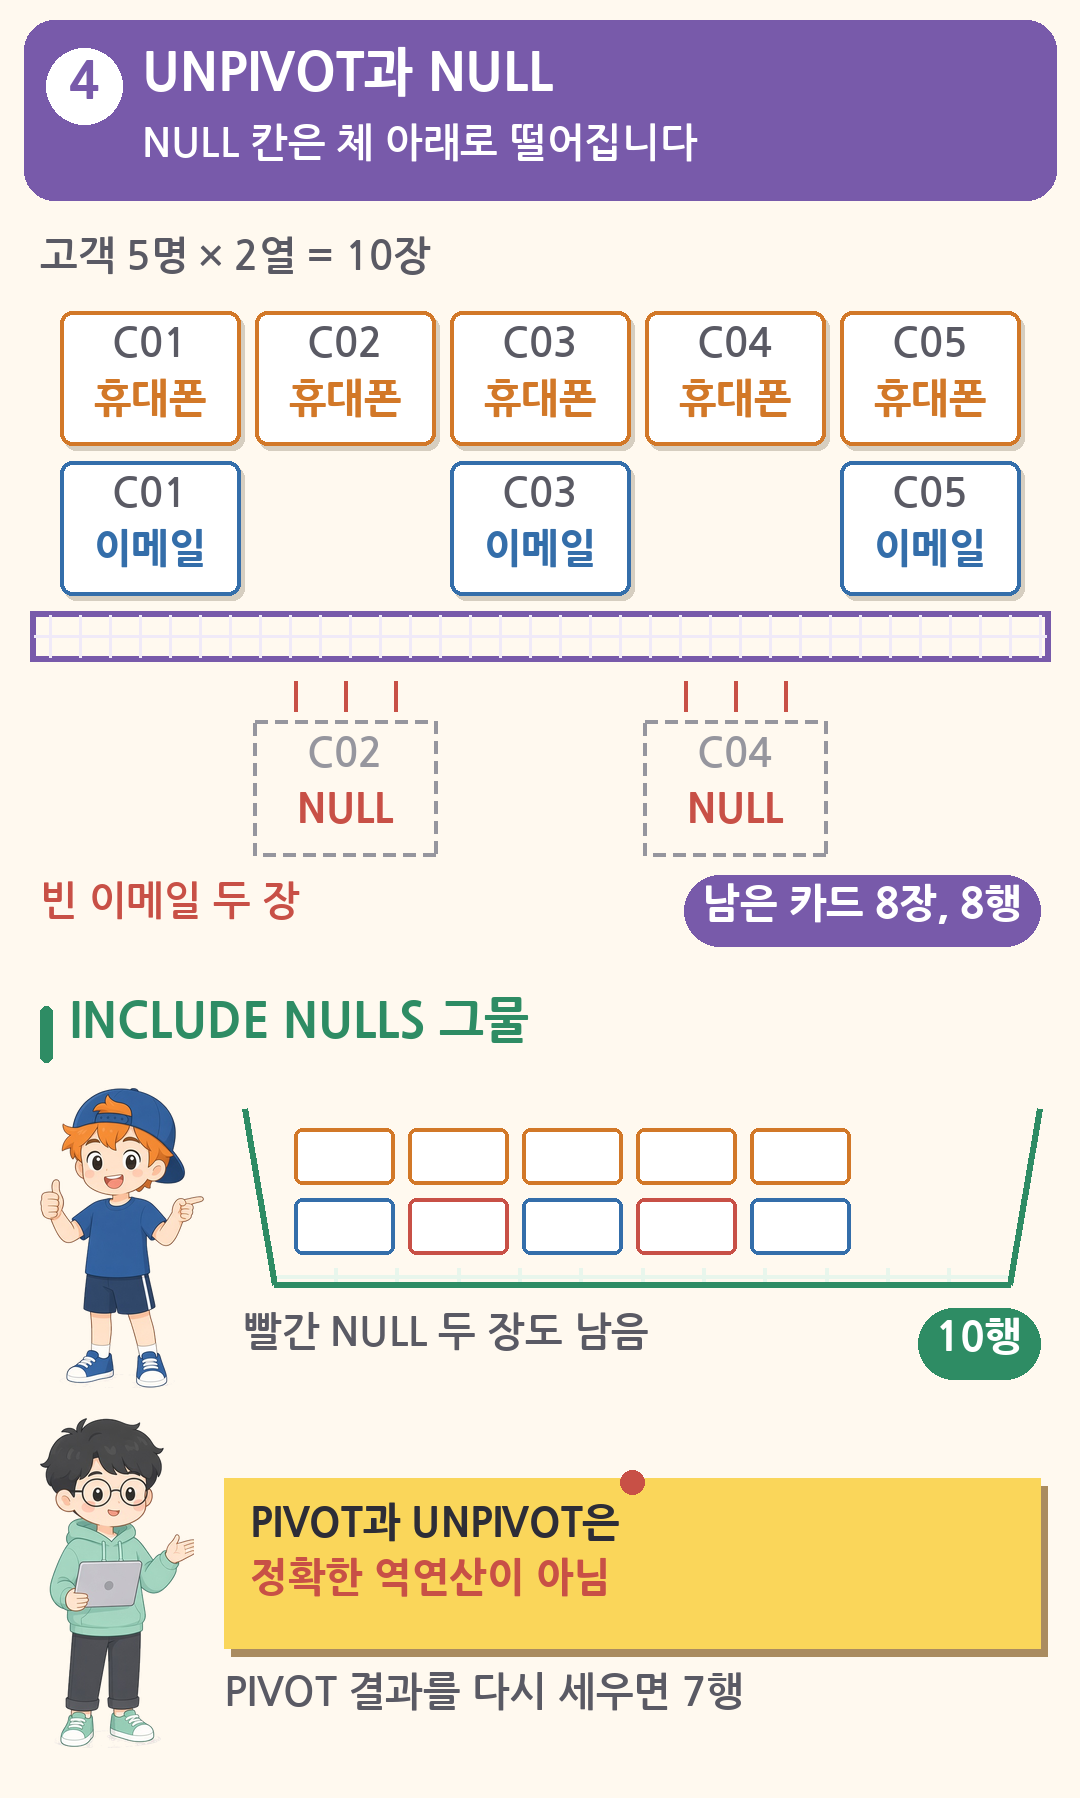
고객의 휴대폰번호와 이메일 두 열을 「연락수단, 연락처」 두 컬럼의 행으로 세웁니다.
SELECT 고객번호, 연락수단, 연락처
  FROM 고객
UNPIVOT (연락처                                          -- ① 값이 들어갈 새 컬럼
         FOR 연락수단                                     -- ② 원래 열 이름이 들어갈 새 컬럼
IN (휴대폰번호 AS '휴대폰', 이메일 AS '이메일')); -- ③ 세울 열들| 고객번호 | 연락수단 | 연락처 |
|---|---|---|
| C01 | 휴대폰 | 01011110001 |
| C01 | 이메일 | hana@example.com |
| C02 | 휴대폰 | 01022220002 |
| C03 | 휴대폰 | 01033330003 |
| C03 | 이메일 | semi@example.com |
| C04 | 휴대폰 | 01044440004 |
| C05 | 휴대폰 | 01055550005 |
| C05 | 이메일 | dasom@example.co.kr |
- 고객 5명 × 2열 = 10칸이지만 결과는 8행입니다. 이메일이 NULL인 C02, C04의 이메일 행은 기본으로 빠집니다.
UNPIVOT INCLUDE NULLS (...)로 쓰면 10행이고 두 행의 연락처가 NULL입니다. - IN 목록에 별칭이 없으면 연락수단 값은 열 이름 그대로(휴대폰번호, 이메일)입니다.
- 세우는 열들은 데이터 타입이 같아야 합니다.
IN (상품명, 판매가)처럼 문자와 숫자를 섞으면 오류(ORA-01790)입니다. - PIVOT 결과를 다시 UNPIVOT하면 NULL 칸이 사라져 7행(B 3, G 2, S 2)만 돌아오고, 합쳐지기 전의 9행도 되살아나지 않습니다. PIVOT과 UNPIVOT은 정확한 역연산이 아닙니다.
- UNPIVOT 이전 방식은 UNION ALL입니다.
SELECT 고객번호, '휴대폰', 휴대폰번호 FROM 고객 UNION ALL SELECT 고객번호, '이메일', 이메일 FROM 고객 WHERE 이메일 IS NOT NULL이 같은 8행입니다.
5. 정규 표현식과 LIKE의 차이
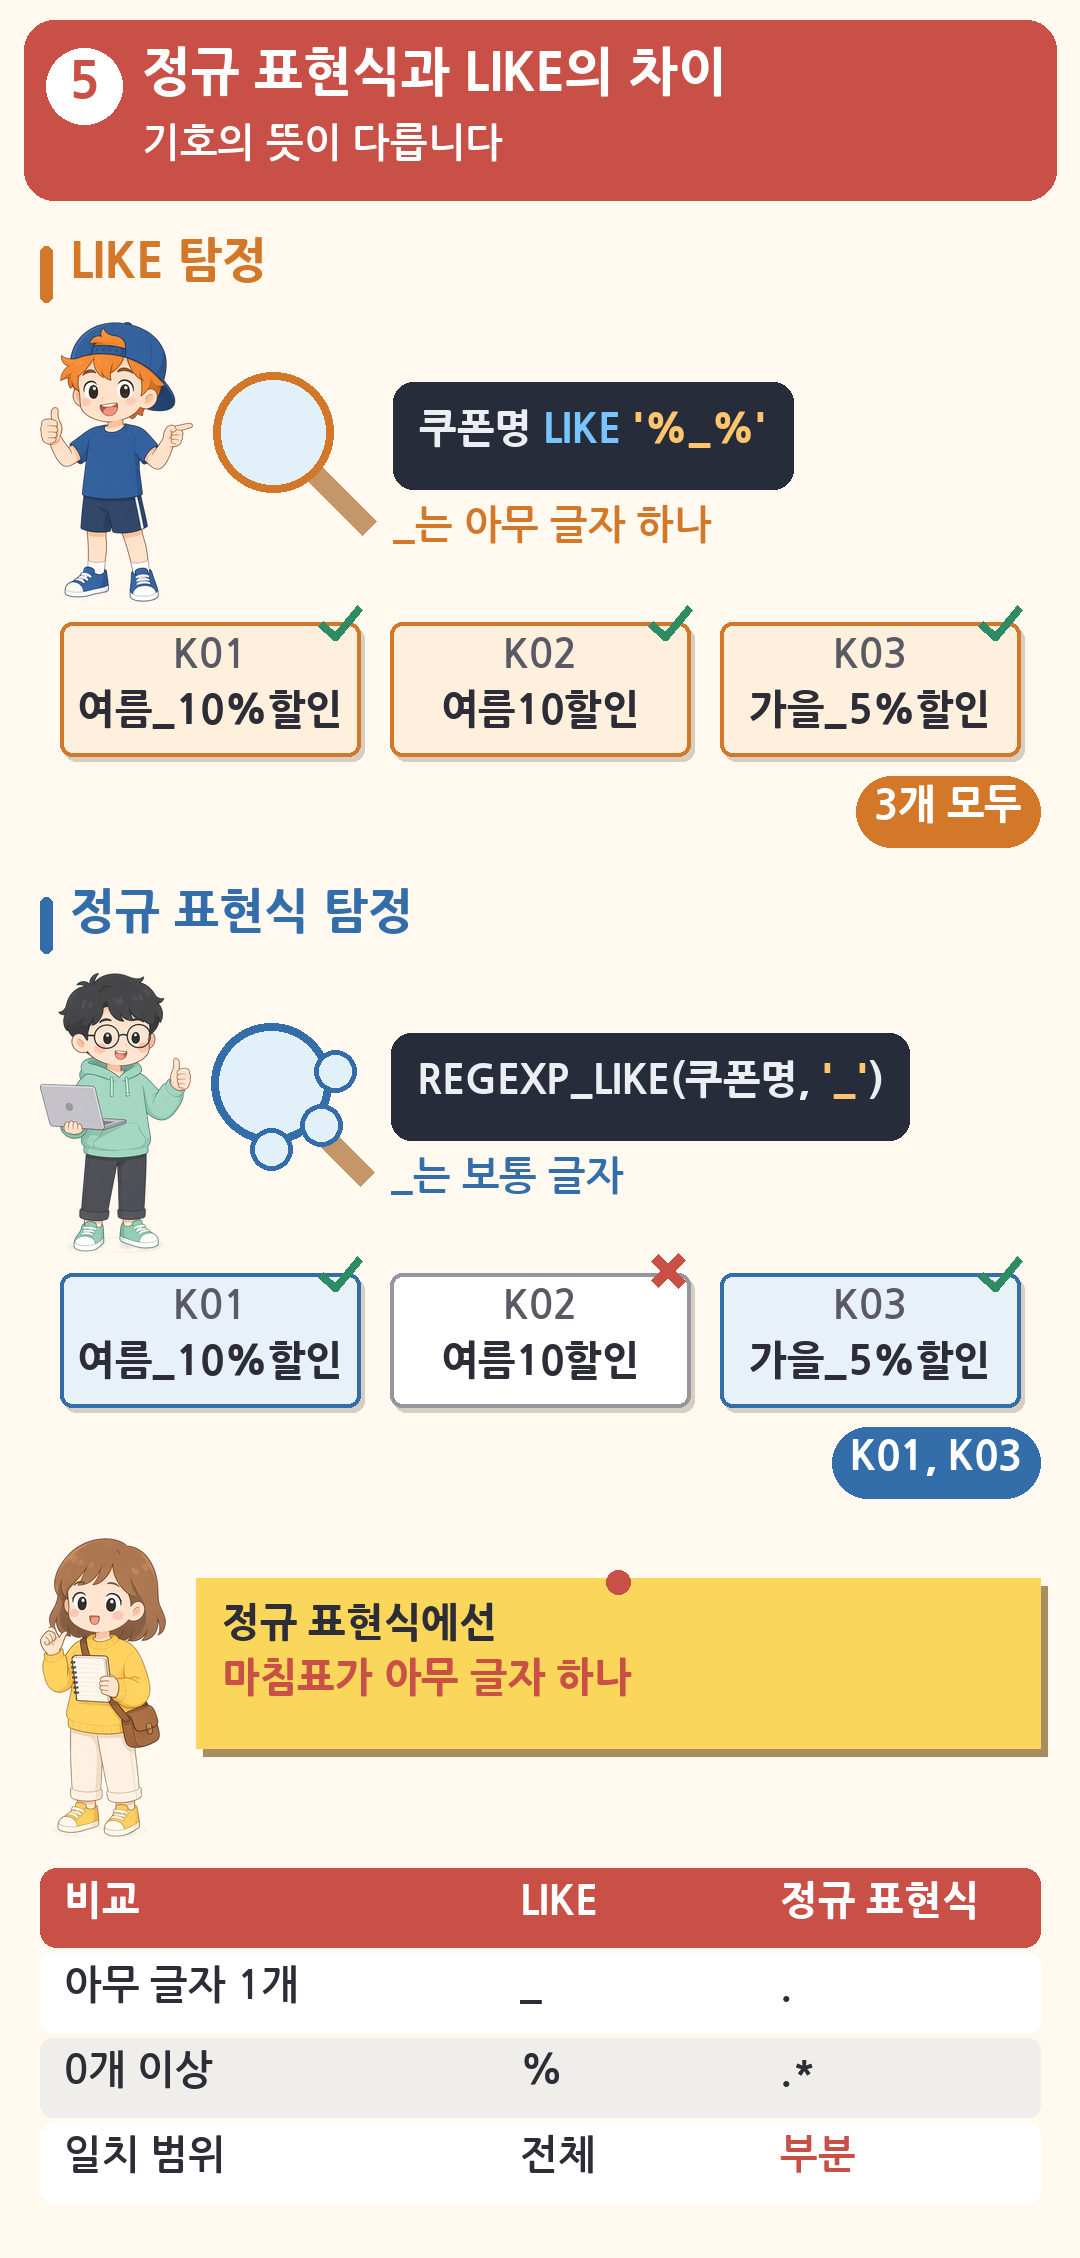
「WHERE 절과 ORDER BY, Top N 쿼리」의 LIKE는 %(0글자 이상)와 _(정확히 1글자) 두 와일드카드만 씁니다. 정규 표현식은 「숫자 3개」, 「영문 소문자로 시작」, 「@ 앞부분」처럼 훨씬 세밀한 패턴을 씁니다. 오라클 정규 표현식은 POSIX 표준을 따르고, \d 같은 Perl식 표현도 일부 지원합니다.
| 비교 | LIKE | 정규 표현식 |
|---|---|---|
| 아무 글자 1개 | _ |
. |
| 아무 글자 0개 이상 | % |
.* |
| 일치 범위 | 패턴이 문자열 전체와 맞아야 함 | 패턴이 문자열 어디든 있으면 일치. 전체는 ^와 $로 감쌈 |
_ 찾기 |
LIKE '%_%'는 쿠폰 3개 모두(_가 아무 글자) |
REGEXP_LIKE(쿠폰명, '_')는 K01, K03(밑줄 글자) |
- 정규 표현식에서
_와%는 보통 글자이고,.이 「아무 글자 하나」입니다. 기호의 뜻이 LIKE와 다릅니다. - 「WHERE 절과 ORDER BY, Top N 쿼리」에서는 밑줄을 글자로 찾으려고
LIKE '%\_%' ESCAPE '\'를 썼습니다. 정규 표현식에서는_가 처음부터 보통 글자라 이스케이프가 필요 없고, 반대로 마침표를 글자로 찾을 때\.이 필요합니다.
6. 정규 표현식 기호
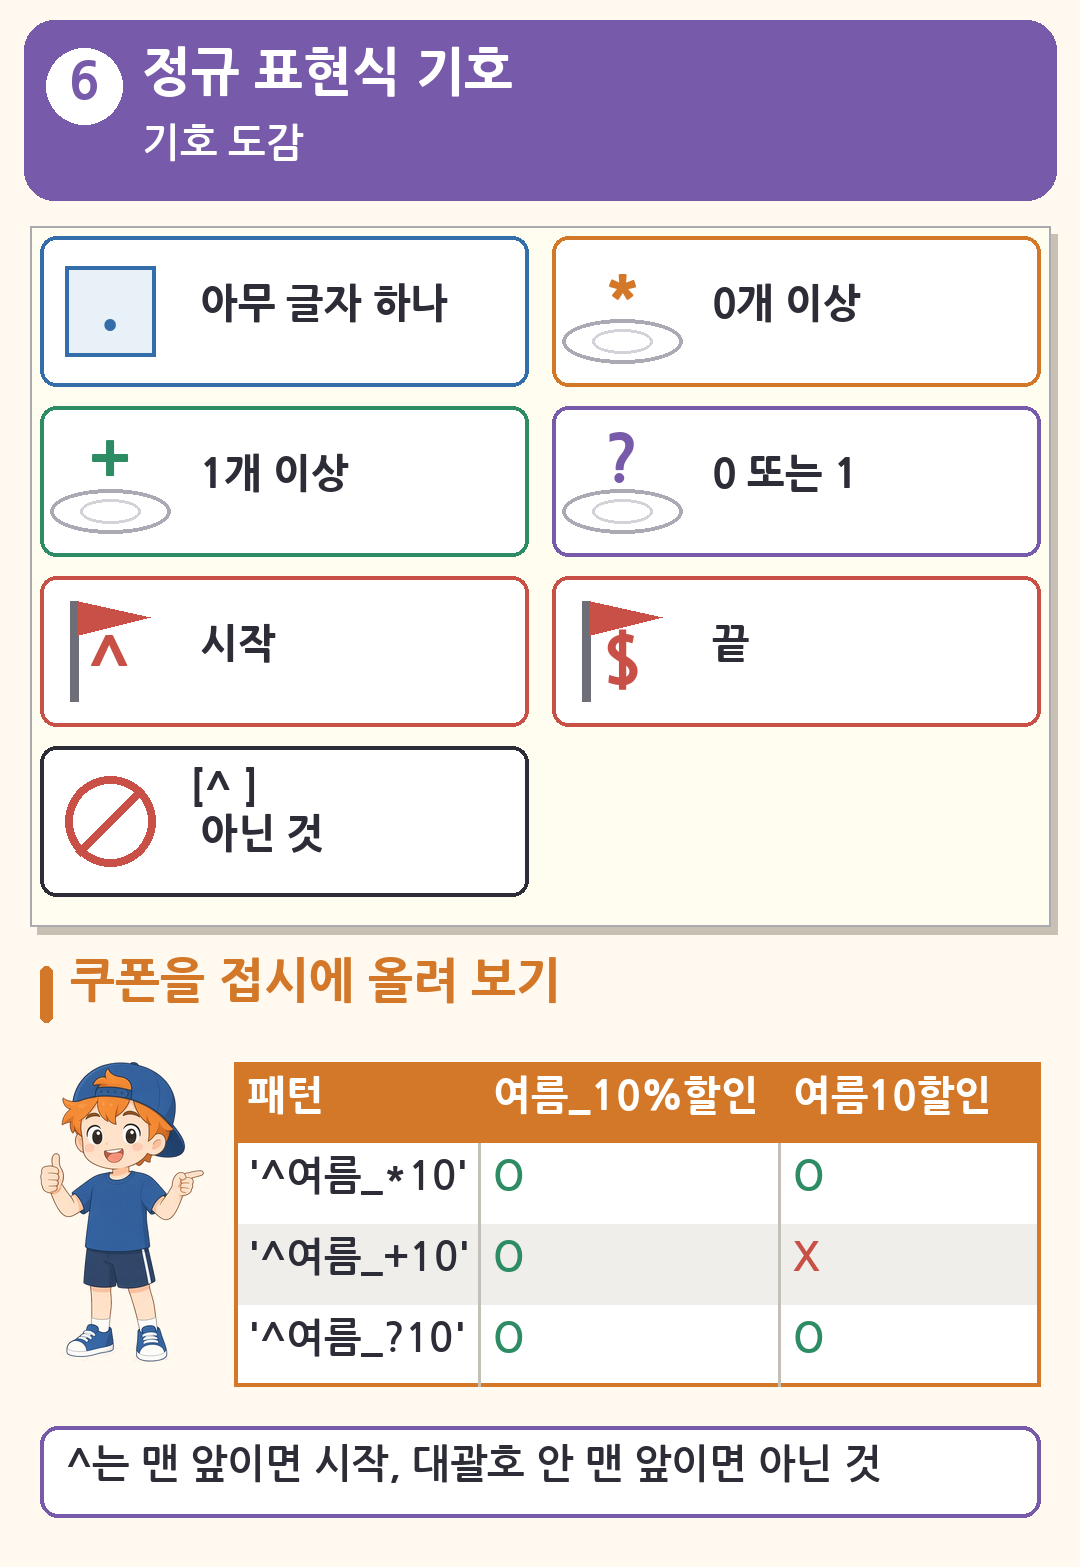
| 기호 | 뜻 | 예 |
|---|---|---|
. |
아무 글자 1개 | '^.$'는 한 글자 상품명 배, 감, 귤 |
* |
앞 요소 0회 이상 | '^여름_*10'은 여름_10%할인, 여름10할인 |
+ |
앞 요소 1회 이상 | '^여름_+10'은 여름_10%할인만 |
? |
앞 요소 0회 또는 1회 | '^여름_?10'은 여름_10%할인, 여름10할인 |
{m}, {m,}, {m,n} |
정확히 m회, m회 이상, m회 이상 n회 이하 | '^010[[:digit:]]{8}$'는 휴대폰번호 5개 모두 |
[ ] |
괄호 안 글자 중 하나 | [a-z]는 영문 소문자 하나 |
[^ ] |
괄호 안 글자가 아닌 글자 하나 | '[^@]+$'는 @ 뒤 도메인 |
^ |
문자열 시작 | '^배'는 배, 배 선물세트 |
$ |
문자열 끝 | '\.com$'은 .com으로 끝나는 이메일(C01, C03) |
( ) |
묶음(하위 표현식) | '(\d{3})(\d{4})(\d{4})' |
\n(n은 1~9) |
n번째 묶음과 같은 문자열(역참조) | '(\d)\1\1\1'은 1111, 2222처럼 같은 숫자 4개 |
\ |
다음 기호를 글자 그대로 | '\.'은 마침표 글자 |
[:digit:], [:alpha:], [:space:] |
문자 클래스. 대괄호 안에 씀 | [[:digit:]]는 숫자 하나 |
\d, \s, \w |
숫자, 공백, 단어 글자. 대문자(\D, \S, \W)는 그 반대 |
\s를 지우면 배선물세트 |
- 「또는」은 세로 막대 기호
|입니다.'사과|배'는 사과, 배, 청사과, 배 선물세트와 일치합니다. ^는 두 가지 뜻입니다. 패턴 맨 앞에서는 「시작」, 대괄호 안 맨 앞에서는 「아닌 것」입니다.'^[^배]'는 배로 시작하지 않는 상품 4개(사과, 감, 귤, 청사과)입니다.*?,+?처럼 뒤에 ?를 붙이면 가능한 한 짧게 일치하는 최소 일치가 됩니다(8장).
7. REGEXP 함수 다섯 가지
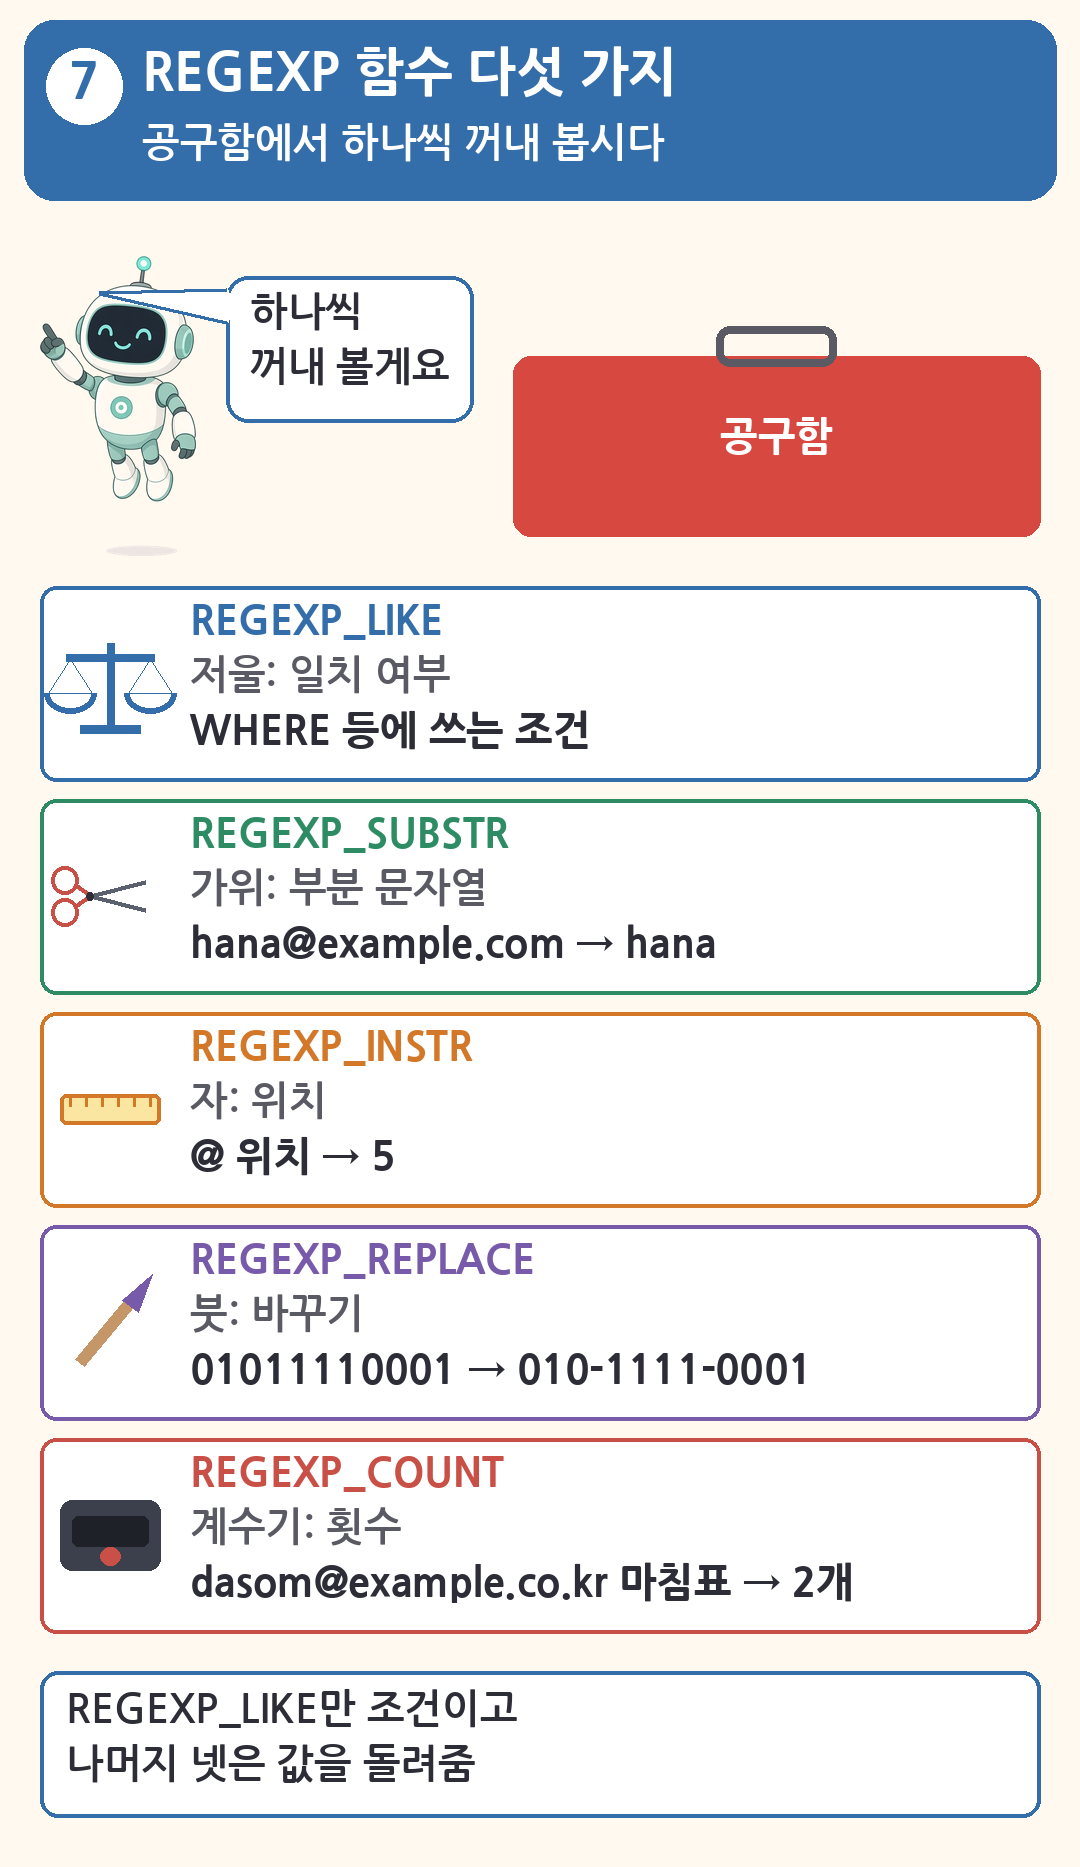
| 함수 | 형식 | 돌려주는 것 |
|---|---|---|
| REGEXP_LIKE | REGEXP_LIKE(원본, 패턴 [, 옵션]) |
조건(참·거짓). WHERE 절 등 조건 자리에 씀 |
| REGEXP_SUBSTR | REGEXP_SUBSTR(원본, 패턴 [, 시작위치 [, 몇번째 [, 옵션 [, 묶음번호]]]]) |
일치한 부분 문자열 |
| REGEXP_INSTR | REGEXP_INSTR(원본, 패턴 [, 시작위치 [, 몇번째 [, 반환옵션 [, 옵션 [, 묶음번호]]]]]) |
위치. 반환옵션 0은 시작 위치, 1은 끝 다음 위치 |
| REGEXP_REPLACE | REGEXP_REPLACE(원본, 패턴 [, 바꿀문자 [, 시작위치 [, 몇번째 [, 옵션]]]]) |
바꾼 문자열. 몇번째를 생략하거나 0이면 전부 |
| REGEXP_COUNT | REGEXP_COUNT(원본, 패턴 [, 시작위치 [, 옵션]]) |
일치 횟수 |
- 옵션은
'i'대소문자 무시,'c'대소문자 구분,'n'마침표가 줄바꿈과도 일치,'m'여러 줄 모드입니다. 생략하면 보통 대소문자를 구분합니다. - 원본이 NULL이면 결과도 NULL입니다. 이메일이 NULL인 C02, C04는 REGEXP_SUBSTR, REGEXP_COUNT 모두 NULL입니다.
이메일 예
C01은 hana@example.com, C05는 dasom@example.co.kr입니다.
| 식 | C01 | C05 |
|---|---|---|
REGEXP_SUBSTR(이메일, '^[^@]+') |
hana | dasom |
REGEXP_SUBSTR(이메일, '[^@]+$') |
example.com | example.co.kr |
REGEXP_SUBSTR(이메일, '[^.]+', 1, 2) |
com | co |
REGEXP_SUBSTR(이메일, '[^.]+', 1, 3) |
NULL | kr |
REGEXP_SUBSTR(이메일, '([^@]+)@(.+)', 1, 1, NULL, 2) |
example.com | example.co.kr |
REGEXP_INSTR(이메일, '@') |
5 | 6 |
REGEXP_INSTR(이메일, 'example') |
6 | 7 |
REGEXP_INSTR(이메일, 'example', 1, 1, 1) |
13 | 14 |
REGEXP_COUNT(이메일, '\.') |
1 | 2 |
REGEXP_LIKE(이메일, '^[a-z]+@[a-z]+\.[a-z]+$') |
일치 | 불일치(점이 두 개) |
REGEXP_LIKE(이메일, '^[a-z]+@[a-z]+(\.[a-z]+)+$') |
일치 | 일치 |
'[^.]+'은 「마침표가 아닌 글자 1개 이상」이라 마침표로 나뉜 조각을 뜻합니다. 대괄호 안의 마침표는 글자 그대로입니다.- 마지막 줄의
(\.[a-z]+)+는 「마침표 + 영문자」 묶음이 1번 이상이라 .co.kr도 일치합니다.
휴대폰번호 예(C01, 01011110001)
| 식 | 결과 |
|---|---|
REGEXP_REPLACE(휴대폰번호, '(\d{3})(\d{4})(\d{4})', '\1-\2-\3') |
010-1111-0001 |
REGEXP_REPLACE(휴대폰번호, '1', '*') |
0*0****000*(전부) |
REGEXP_REPLACE(휴대폰번호, '1', '*', 1, 1) |
0*011110001(첫 번째만) |
REGEXP_REPLACE(휴대폰번호, '1', '*', 1, 2) |
010*1110001(두 번째만) |
REGEXP_REPLACE(휴대폰번호, '1', '*', 5) |
0101***000*(5번째 글자부터 전부) |
REGEXP_SUBSTR(휴대폰번호, '(\d)\1\1\1') |
1111 |
쿠폰명 예
쿠폰명 세 값(여름_10%할인, 여름10할인, 가을_5%할인)은 「WHERE 절과 ORDER BY, Top N 쿼리」의 ESCAPE 예와 같습니다.
| 식 | K01, K02, K03 결과 |
|---|---|
REGEXP_SUBSTR(쿠폰명, '\d+') |
10, 10, 5 |
REGEXP_REPLACE(쿠폰명, '[^0-9]', '') |
10, 10, 5 |
REGEXP_LIKE(쿠폰명, '\d+%') |
일치, 불일치, 일치 |
REGEXP_LIKE(쿠폰명, '_') |
일치, 불일치, 일치 |
8. 정규 표현식 함정 세 가지
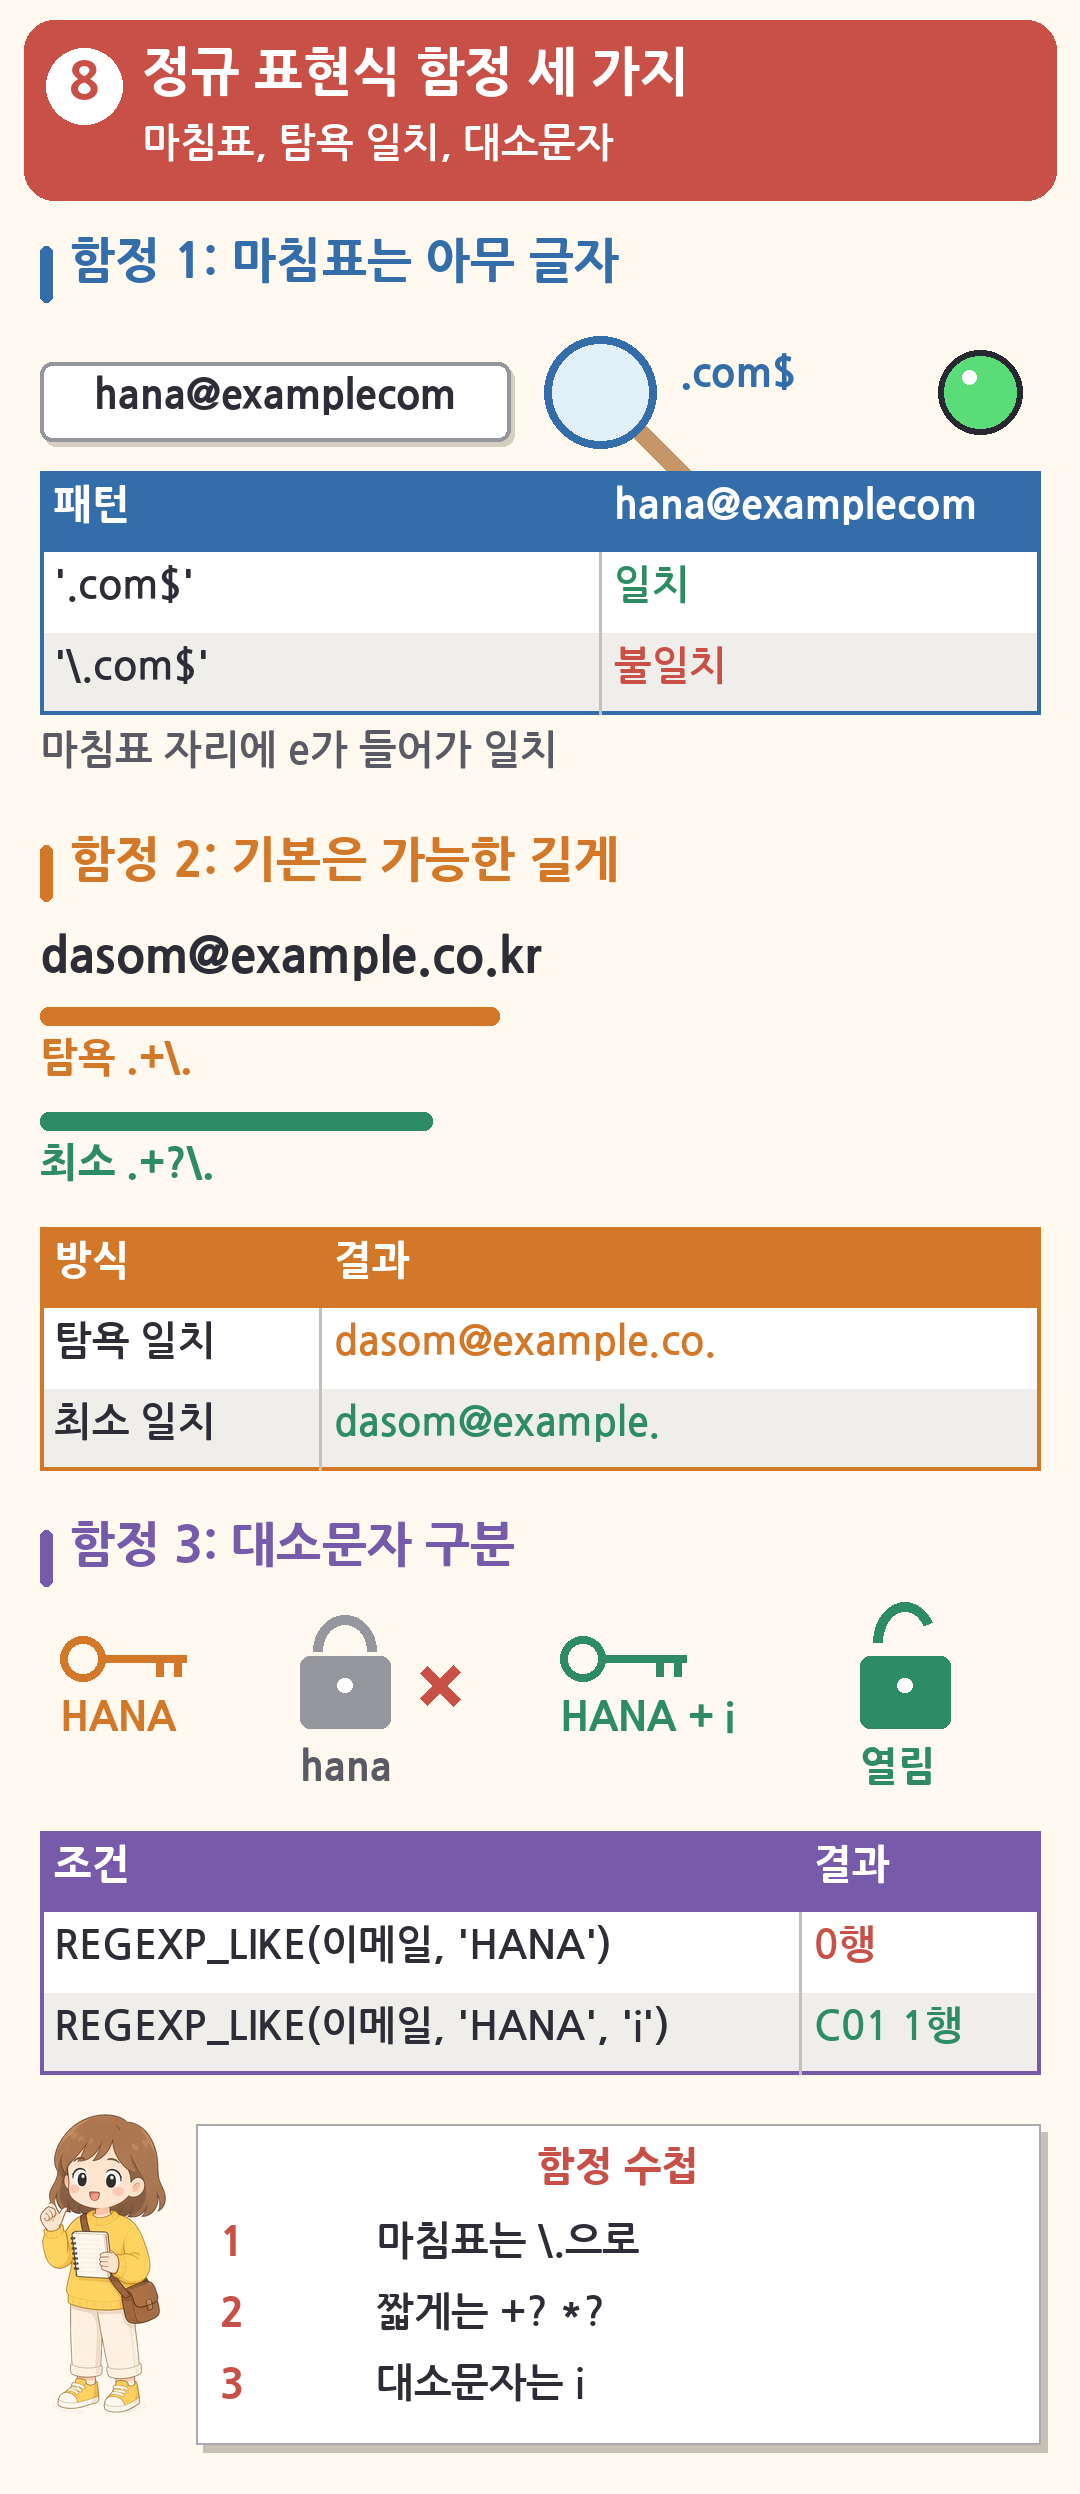
| 함정 | 예 | 결과 |
|---|---|---|
| 마침표를 이스케이프하지 않음 | REGEXP_LIKE('hana@examplecom', '.com$') |
일치(.이 아무 글자라 e와 일치) |
| 마침표를 이스케이프함 | REGEXP_LIKE('hana@examplecom', '\.com$') |
불일치 |
| 탐욕(greedy) 일치 | REGEXP_SUBSTR('dasom@example.co.kr', '.+\.') |
dasom@example.co.(가능한 길게) |
| 최소(nongreedy) 일치 | REGEXP_SUBSTR('dasom@example.co.kr', '.+?\.') |
dasom@example.(가능한 짧게) |
| 대소문자 구분 | WHERE REGEXP_LIKE(이메일, 'HANA') |
0행 |
| 옵션 i로 무시 | WHERE REGEXP_LIKE(이메일, 'HANA', 'i') |
C01 1행 |
- 실제 데이터의 C01, C03 이메일은
'.com$'과'\.com$'의 결과가 같아서(둘 다 2행) 차이가 보이지 않습니다. 시험은 이런 「우연히 맞는 패턴」을 보기로 냅니다. +,*는 기본으로 가능한 한 길게 일치합니다. 짧게 끊으려면+?,*?를 씁니다.
9. SQL Server와의 차이

| 항목 | 오라클 | SQL Server |
|---|---|---|
| PIVOT IN 목록 | 값 리터럴 IN ('L' AS 저가, ...) |
열 이름 식별자 IN ([L], [M], [V]) |
| PIVOT 결과 별칭 | 생략 가능 | 원본 파생 테이블과 PIVOT 결과에 별칭 필요 |
| UNPIVOT의 NULL | 기본 제외, INCLUDE NULLS로 포함 | 제외(INCLUDE NULLS 옵션 없음) |
| UNPIVOT 열 타입 | 같은 타입 계열 | 타입과 길이까지 같아야 함(CAST로 맞춤) |
| 정규 표현식 | REGEXP 함수 다섯 가지 | 오랫동안 없었고 최근 버전부터 지원. LIKE의 대괄호 패턴을 씀 |
- SQL Server에서 같은 PIVOT을 쓰면 값은 오라클과 같고 열 이름이 L, M, V가 됩니다.
- SQL Server의 LIKE는
[0-9],[^a]같은 대괄호 패턴을 쓸 수 있습니다. 예를 들어휴대폰번호 LIKE '010[0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9]'는 5행입니다. 시험의 정규 표현식 문제는 오라클 기준입니다.
10. 헷갈리기 쉬운 점
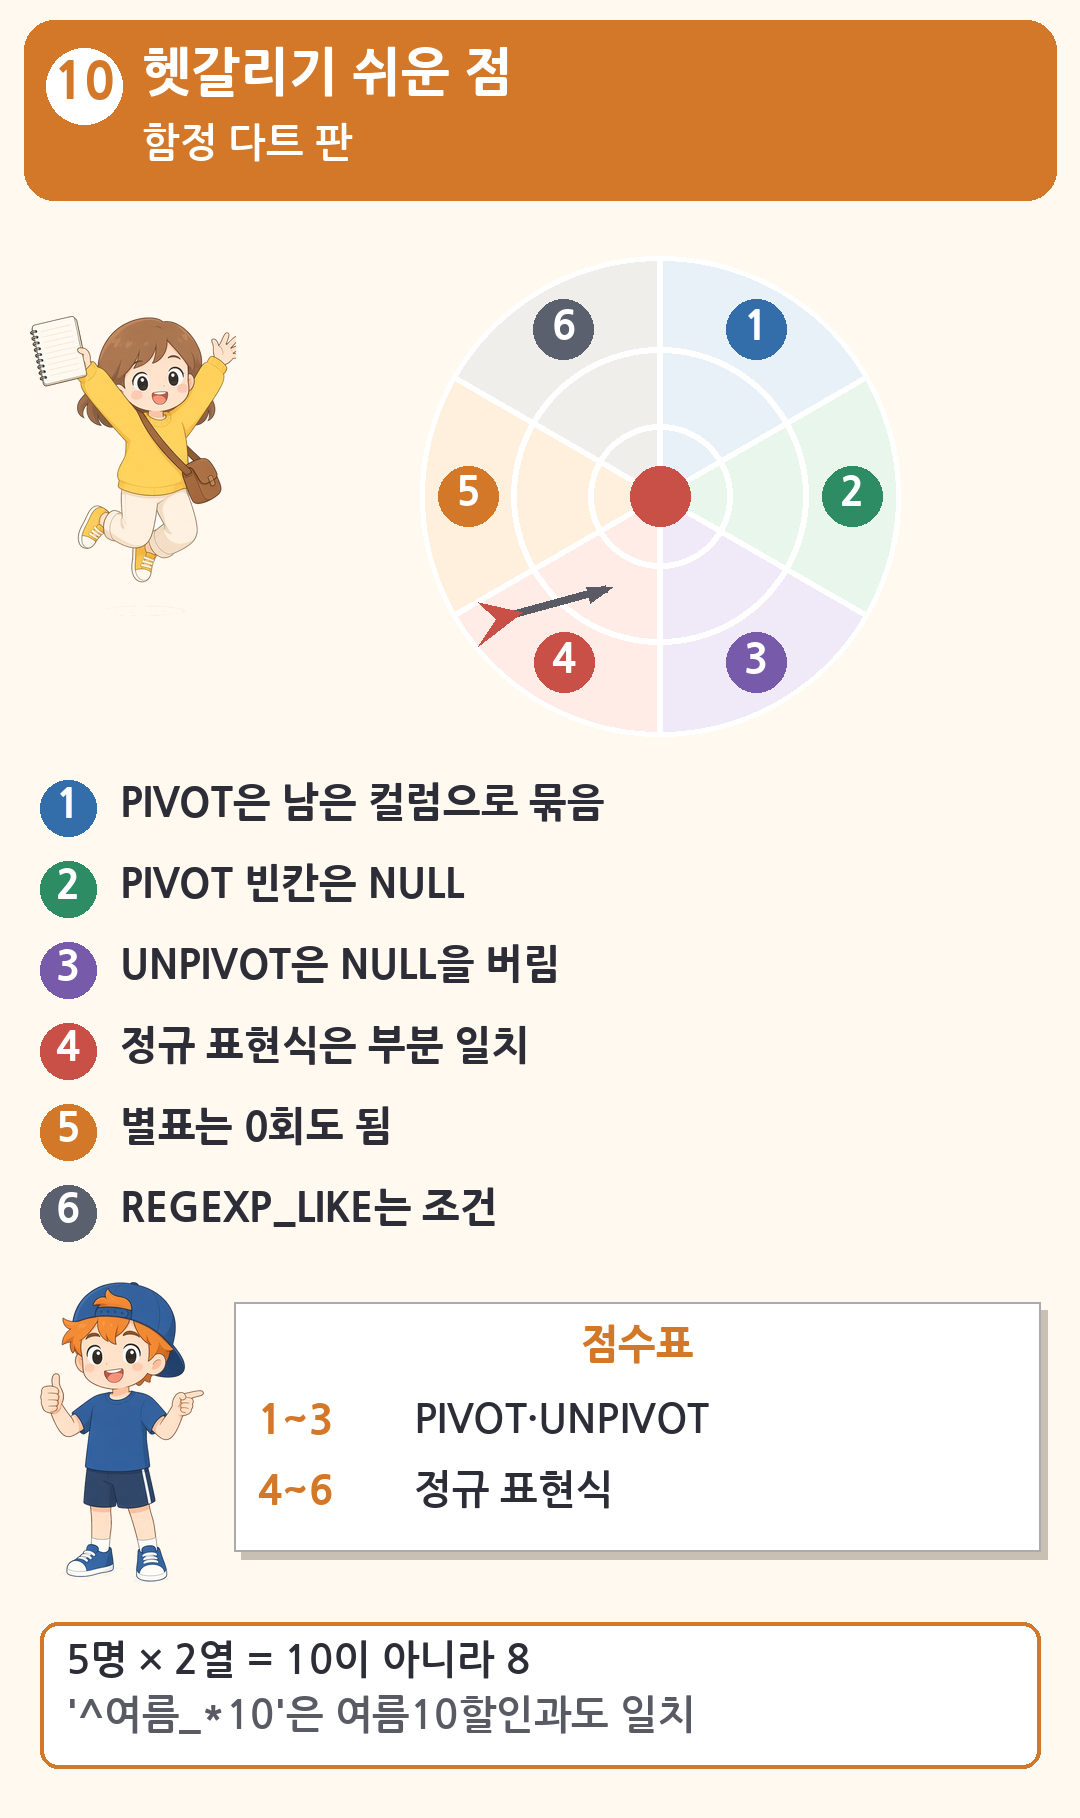
- PIVOT은 남은 컬럼으로 묶습니다. 원본에 컬럼이 하나 더 있으면 행 수가 늘어납니다. 결과 행 수 문제는 PIVOT 괄호 밖에 남은 컬럼을 셉니다.
- PIVOT의 빈칸은 NULL입니다. 0으로 보이려면 바깥 SELECT에서 NVL을 쓰거나, CASE 방식에서 ELSE 0을 씁니다.
- UNPIVOT은 NULL 칸을 버립니다. 5명 × 2열 = 10이 아니라 8입니다. 포함하려면 INCLUDE NULLS를 씁니다.
- 정규 표현식은 부분 일치입니다.
REGEXP_LIKE(상품명, '배')는 배, 배 선물세트와 모두 일치합니다. 전체 일치는^와$로 감쌉니다. ^는 두 가지 뜻입니다. 패턴 맨 앞은 「시작」, 대괄호 안 맨 앞은 「아닌 것」입니다.*는 0회도 됩니다.'^여름_*10'은 밑줄이 없는 여름10할인과도 일치합니다. 1회 이상은+입니다.- 정규 표현식의 마침표는 아무 글자입니다. 마침표 글자를 찾으려면
\.으로 씁니다. 반대로_와%는 보통 글자입니다. - REGEXP_REPLACE의 몇번째 인수를 생략하면 전부 바꿉니다. 첫 번째만 바꾸려면 시작위치 1, 몇번째 1을 줍니다.
- REGEXP_LIKE는 조건입니다. 값을 돌려주는 다른 네 함수와 달리 WHERE 절 등 조건 자리에 씁니다.
11. 연습 문제
PIVOT의 결과 행 수, UNPIVOT과 NULL, 정규 표현식 패턴과 함수 결과를 확인하는 문제입니다. 실제 시험과 같은 유형으로 새로 만들었습니다. 정답과 풀이는 다음 장에 있으니, 먼저 직접 풀어 보세요.
문제 1. [판매] 테이블이 다음과 같을 때, 두 SQL의 결과 행 수를 차례로 고르면?
[판매]
| 등급코드 | 주문번호 | 가격대코드 | 금액 |
|---|---|---|---|
| B | 5004 | M | 12000 |
| B | 5007 | L | 4000 |
| B | 5007 | V | 25000 |
| G | 5001 | M | 10000 |
| G | 5003 | L | 6000 |
| G | 5006 | M | 8000 |
| S | 5002 | M | 3000 |
| S | 5005 | L | 2000 |
| S | 5005 | M | 6000 |
-- (가)
SELECT *
  FROM (SELECT 등급코드, 가격대코드, 금액 FROM 판매)
 PIVOT (SUM(금액) FOR 가격대코드 IN ('L' AS 저가, 'M' AS 중가, 'V' AS 선물용));

-- (나)
SELECT *
  FROM 판매
 PIVOT (SUM(금액) FOR 가격대코드 IN ('L' AS 저가, 'M' AS 중가, 'V' AS 선물용));
① 3, 3
② 3, 7
③ 3, 9
④ 9, 9
문제 2. [고객] 테이블이 다음과 같을 때, SQL의 결과 행 수는?
[고객]
| 고객번호 | 휴대폰번호 | 이메일 |
|---|---|---|
| C01 | 01011110001 | hana@example.com |
| C02 | 01022220002 | NULL |
| C03 | 01033330003 | semi@example.com |
| C04 | 01044440004 | NULL |
| C05 | 01055550005 | dasom@example.co.kr |
SELECT 고객번호, 연락수단, 연락처
  FROM 고객
UNPIVOT (연락처 FOR 연락수단 IN (휴대폰번호, 이메일));
① 5
② 8
③ 10
④ 오류가 발생한다
문제 3. 문제 2의 [고객] 테이블에서 다음 SQL의 결과 행 수는?
SELECT 고객번호
  FROM 고객
 WHERE REGEXP_LIKE(이메일, '^[a-z]+@[a-z]+\.[a-z]+$');
① 2
② 3
③ 4
④ 5
문제 4. [쿠폰] 테이블의 쿠폰명이 '여름_10%할인', '여름10할인', '가을_5%할인' 세 개일 때, '여름_10%할인' 한 행만 일치하는 조건은?
① REGEXP_LIKE(쿠폰명, '_')
② REGEXP_LIKE(쿠폰명, '^여름_?10')
③ REGEXP_LIKE(쿠폰명, '^여름_*10')
④ REGEXP_LIKE(쿠폰명, '^여름_+10')
문제 5. 정규 표현식에 대한 설명으로 가장 적절하지 않은 것은?
① REGEXP_COUNT('dasom@example.co.kr', '\.')의 결과는 2이다.
② REGEXP_SUBSTR('hana@example.com', '[^@]+$')의 결과는 'example.com'이다.
③ 정규 표현식에서 .은 마침표 한 글자만 뜻하므로 REGEXP_LIKE('hana@examplecom', '.com$')은 거짓이다.
④ REGEXP_INSTR('hana@example.com', '@')의 결과는 5이다.
12. 풀이
문제 1. 정답 ②
(가)는 인라인 뷰에 등급코드, 가격대코드, 금액만 있으므로 등급코드로만 묶여 3행입니다(B 4000·12000·25000, G 6000·18000·NULL, S 2000·9000·NULL). (나)는 PIVOT에 쓰이지 않은 주문번호도 그룹 기준이 되어 (등급코드, 주문번호) 조합 7행입니다.
문제 2. 정답 ②
5명 × 2열 = 10칸 중 이메일이 NULL인 2칸은 기본으로 제외되어 8행입니다. UNPIVOT INCLUDE NULLS라면 10행입니다.
문제 3. 정답 ①
C01, C03은 일치합니다. C05는 @ 뒤에 마침표가 두 개라 [a-z]+\.[a-z]+$와 맞지 않고, C02와 C04는 이메일이 NULL이라 조건이 참이 되지 않습니다.
문제 4. 정답 ④_+는 밑줄이 1개 이상이어야 하므로 '여름_10%할인'만 일치합니다. ①은 밑줄이 있는 K01, K03 두 행이고, ②의 _?(0회 또는 1회)와 ③의 _*(0회 이상)는 밑줄이 없는 '여름10할인'까지 두 행입니다.
문제 5. 정답 ③
정규 표현식의 .은 「아무 글자 하나」라서 'examplecom'의 e와 일치하므로 참입니다. 마침표 글자만 찾으려면 \.com$으로 쓰고, 이때는 거짓입니다. ①은 마침표 2개, ②는 @ 뒤 전체, ④는 @의 위치 5로 모두 맞는 설명입니다.
마치며
이번 글에서는 PIVOT·UNPIVOT과 정규 표현식을 정리했습니다.
- PIVOT은 행 값을 열로 펼치며, 집계 함수가 반드시 있어야 하고 PIVOT에 쓰이지 않은 컬럼이 모두 그룹 기준이 됩니다. 예시에서 인라인 뷰로 고르면 3행, 주문번호가 남으면 7행입니다.
- PIVOT의 빈칸은 NULL이고, 같은 결과를 CASE·DECODE + GROUP BY로도 만들 수 있습니다.
- UNPIVOT은 열을 행으로 세우며 기본으로 NULL을 버립니다. 고객 5명 × 2열에서 8행, INCLUDE NULLS면 10행입니다.
- 정규 표현식은 부분 일치이고,
.은 아무 글자,*는 0회 이상,+는 1회 이상,?는 0회 또는 1회,^와$는 시작과 끝입니다. - REGEXP_LIKE는 조건이고, REGEXP_SUBSTR·REGEXP_INSTR·REGEXP_REPLACE·REGEXP_COUNT는 값을 돌려줍니다. REGEXP_REPLACE는 몇번째를 생략하면 전부 바꿉니다.
다음 글 「관리 구문, DML·TCL·DDL·DCL 정리」에서는 데이터를 넣고 고치고 지우는 DML과 MERGE, COMMIT·ROLLBACK·SAVEPOINT, CREATE·ALTER·DROP·TRUNCATE와 제약조건, GRANT·REVOKE와 ROLE을 쇼핑몰 예시로 살펴보고 기출 유형 문제로 확인합니다.
참고 자료(공식)
- 데이터자격검정, SQL 개발자(SQLD) 안내: 출제 범위
- Oracle Database SQL Language Reference, SELECT(pivot_clause, unpivot_clause)
- Oracle Database SQL Language Reference, Oracle Regular Expression Support
- Oracle Database SQL Language Reference, Pattern-matching Conditions
- Oracle Database SQL Language Reference, REGEXP_SUBSTR
- Oracle Database SQL Language Reference, REGEXP_REPLACE
- Microsoft Learn, FROM - Using PIVOT and UNPIVOT
'DB' 카테고리의 다른 글
| 관리 구문, DML·TCL·DDL·DCL 정리 (0) | 2026.10.12 |
|---|---|
| 계층형 질의와 셀프 조인 (0) | 2026.10.08 |
| 윈도우 함수, 순위·집계·LAG/LEAD (0) | 2026.10.08 |
| 집합 연산자와 ROLLUP·CUBE·GROUPING SETS (0) | 2026.10.08 |
| 서브쿼리 종류와 NOT IN의 NULL 함정 (0) | 2026.10.08 |


