윈도우 함수, 순위·집계·LAG/LEAD
목차
SQLD 2과목의 「윈도우 함수」 항목을 정리합니다. 윈도우 함수의 뜻과 OVER 절 구성, 쓸 수 있는 위치, 순위 함수 RANK·DENSE_RANK·ROW_NUMBER의 동점 처리, PARTITION BY와 그룹별 1등 찾기, 집계 윈도우 함수와 누적합, 윈도우 절 ROWS와 RANGE의 차이, FIRST_VALUE·LAST_VALUE·LAG·LEAD, 비율 함수 RATIO_TO_REPORT·PERCENT_RANK·CUME_DIST·NTILE, SQL Server와의 차이를 쇼핑몰 예시로 살펴본 뒤 기출 유형 연습 문제 5개로 확인합니다.
앞 글 「집합 연산자와 ROLLUP·CUBE·GROUPING SETS」에서 소계와 총계를 한 번에 만드는 그룹 함수를 정리했습니다. GROUP BY와 그룹 함수는 여러 행을 묶어 행 수를 줄입니다. 이번에 다루는 윈도우 함수는 행 수를 그대로 두고, 행마다 「같은 묶음 안에서의 순위, 합계, 앞뒤 행의 값」을 옆에 붙입니다. 예시 데이터는 앞 글들과 같은 쇼핑몰 테이블과 가격대 테이블이고, 주문별 금액과 상품 판매가를 주로 씁니다. 연습 문제는 실제 시험과 같은 유형으로 새로 만든 문제입니다.
1. 윈도우 함수란
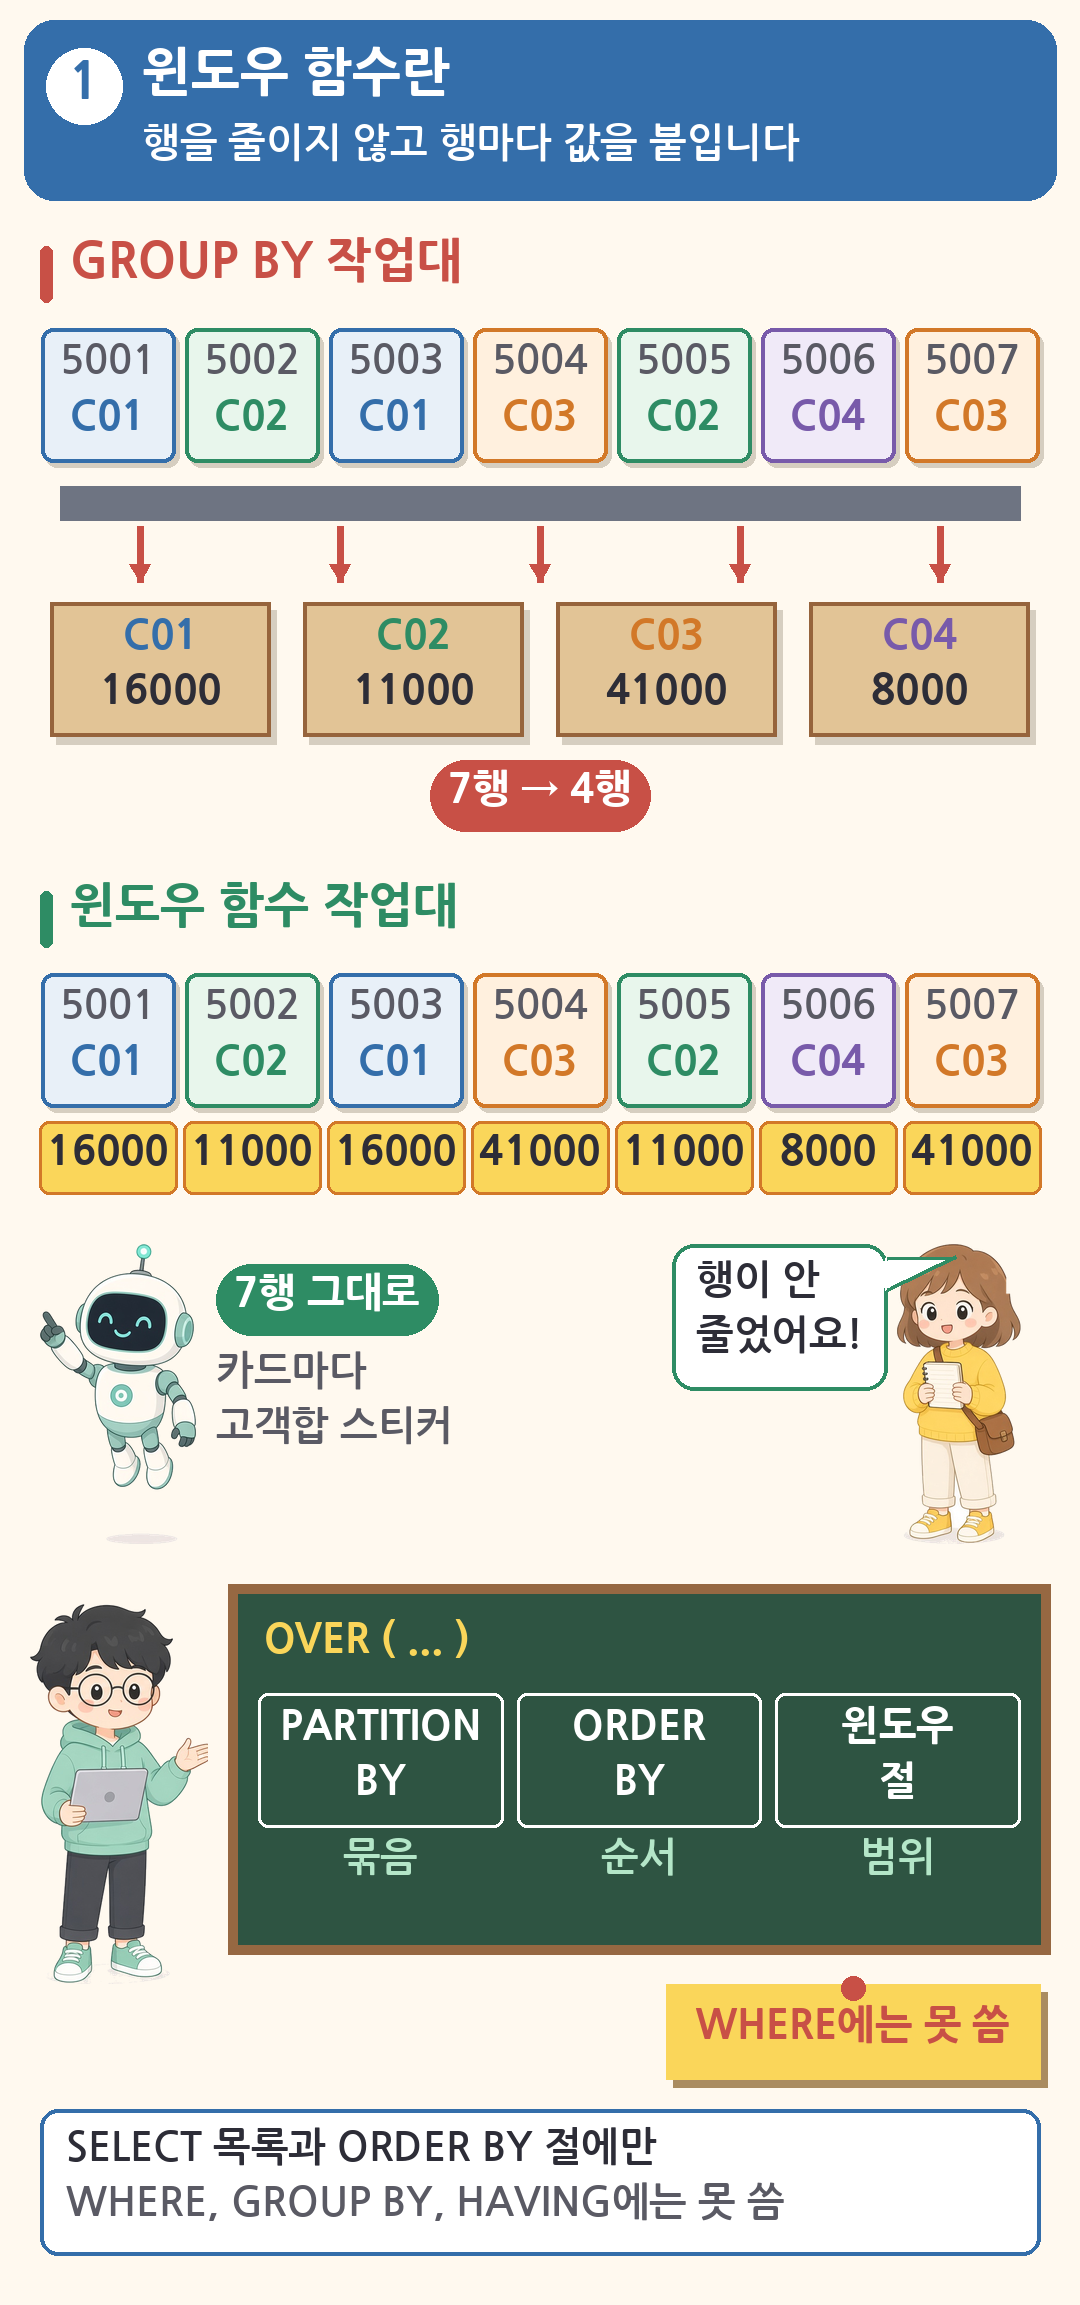
윈도우 함수는 함수 뒤에 OVER 절을 붙여 씁니다. 오라클 문서는 분석 함수(analytic function), 수험서와 SQL Server 문서는 윈도우 함수라고 부르는데 같은 것입니다.
함수명(인수) OVER ( [PARTITION BY 컬럼]          -- 묶음 나누기
                    [ORDER BY 컬럼 [ASC | DESC]]  -- 묶음 안 순서
[ROWS | RANGE 윈도우 절] ) -- 계산에 넣을 행 범위| 구성 | 하는 일 | 생략하면 |
|---|---|---|
| PARTITION BY | 묶음(파티션)을 나눔. GROUP BY와 비슷하지만 행을 줄이지 않음 | 결과 전체가 한 파티션 |
| ORDER BY | 파티션 안의 순서. 순위, LAG, 누적 계산의 기준 | 순위 함수와 LAG·LEAD는 오류(ORA-30485). 집계 함수는 파티션 전체 집계 |
| 윈도우 절 | 현재 행을 기준으로 계산에 넣을 범위 | ORDER BY가 있으면 RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW |
- 윈도우 함수는 FROM, WHERE, GROUP BY, HAVING이 모두 끝난 뒤, 마지막 ORDER BY 바로 앞에서 계산됩니다. 그래서 SELECT 목록과 ORDER BY 절에만 쓸 수 있고 WHERE, GROUP BY, HAVING에는 쓸 수 없습니다.
WHERE RANK() OVER (ORDER BY 판매가 DESC) <= 3처럼 쓰면 오류(ORA-30483)입니다. 순위로 거르려면 인라인 뷰 안에서 순위를 매기고 바깥에서 거릅니다(3장).
윈도우 함수의 네 가지 분류
| 분류 | 함수 | 핵심 |
|---|---|---|
| 순위 함수 | RANK, DENSE_RANK, ROW_NUMBER | 동점 처리 방법이 다름 |
| 집계 함수 | SUM, AVG, COUNT, MAX, MIN | OVER를 붙이면 행을 줄이지 않는 집계 |
| 행 순서 함수 | FIRST_VALUE, LAST_VALUE, LAG, LEAD | 처음, 끝, 앞, 뒤 행의 값 |
| 비율 함수 | RATIO_TO_REPORT, PERCENT_RANK, CUME_DIST, NTILE | 비율, 백분위, 등분 |
예시 데이터: 주문별 금액
주문상품을 주문별로 더한 금액입니다. 「서브쿼리 종류와 NOT IN의 NULL 함정」에서 인라인 뷰로 만든 주문별 금액과 같은 숫자이고, 이 글에서는 WITH 절로 이름(금액)을 붙여 씁니다.
WITH 금액 AS (
  SELECT o.주문번호, o.고객번호, o.주문일시,
         SUM(oi.주문수량 * oi.주문단가) AS 주문금액
    FROM 주문 o JOIN 주문상품 oi ON o.주문번호 = oi.주문번호
   GROUP BY o.주문번호, o.고객번호, o.주문일시
)
SELECT ... FROM 금액 ...;| 주문번호 | 고객번호 | 주문일시 | 주문금액 |
|---|---|---|---|
| 5001 | C01 | 10-01 10:15 | 10000 |
| 5002 | C02 | 10-02 14:30 | 3000 |
| 5003 | C01 | 10-03 09:05 | 6000 |
| 5004 | C03 | 10-04 18:20 | 12000 |
| 5005 | C02 | 10-05 20:40 | 8000 |
| 5006 | C04 | 10-06 11:00 | 8000 |
| 5007 | C03 | 10-07 16:45 | 29000 |
판매가 4000(배, 청사과)과 주문금액 8000(5005, 5006)이 동점이라, 동점에서 결과가 갈리는 함수들을 비교하기 좋습니다.
2. 순위 함수: RANK, DENSE_RANK, ROW_NUMBER
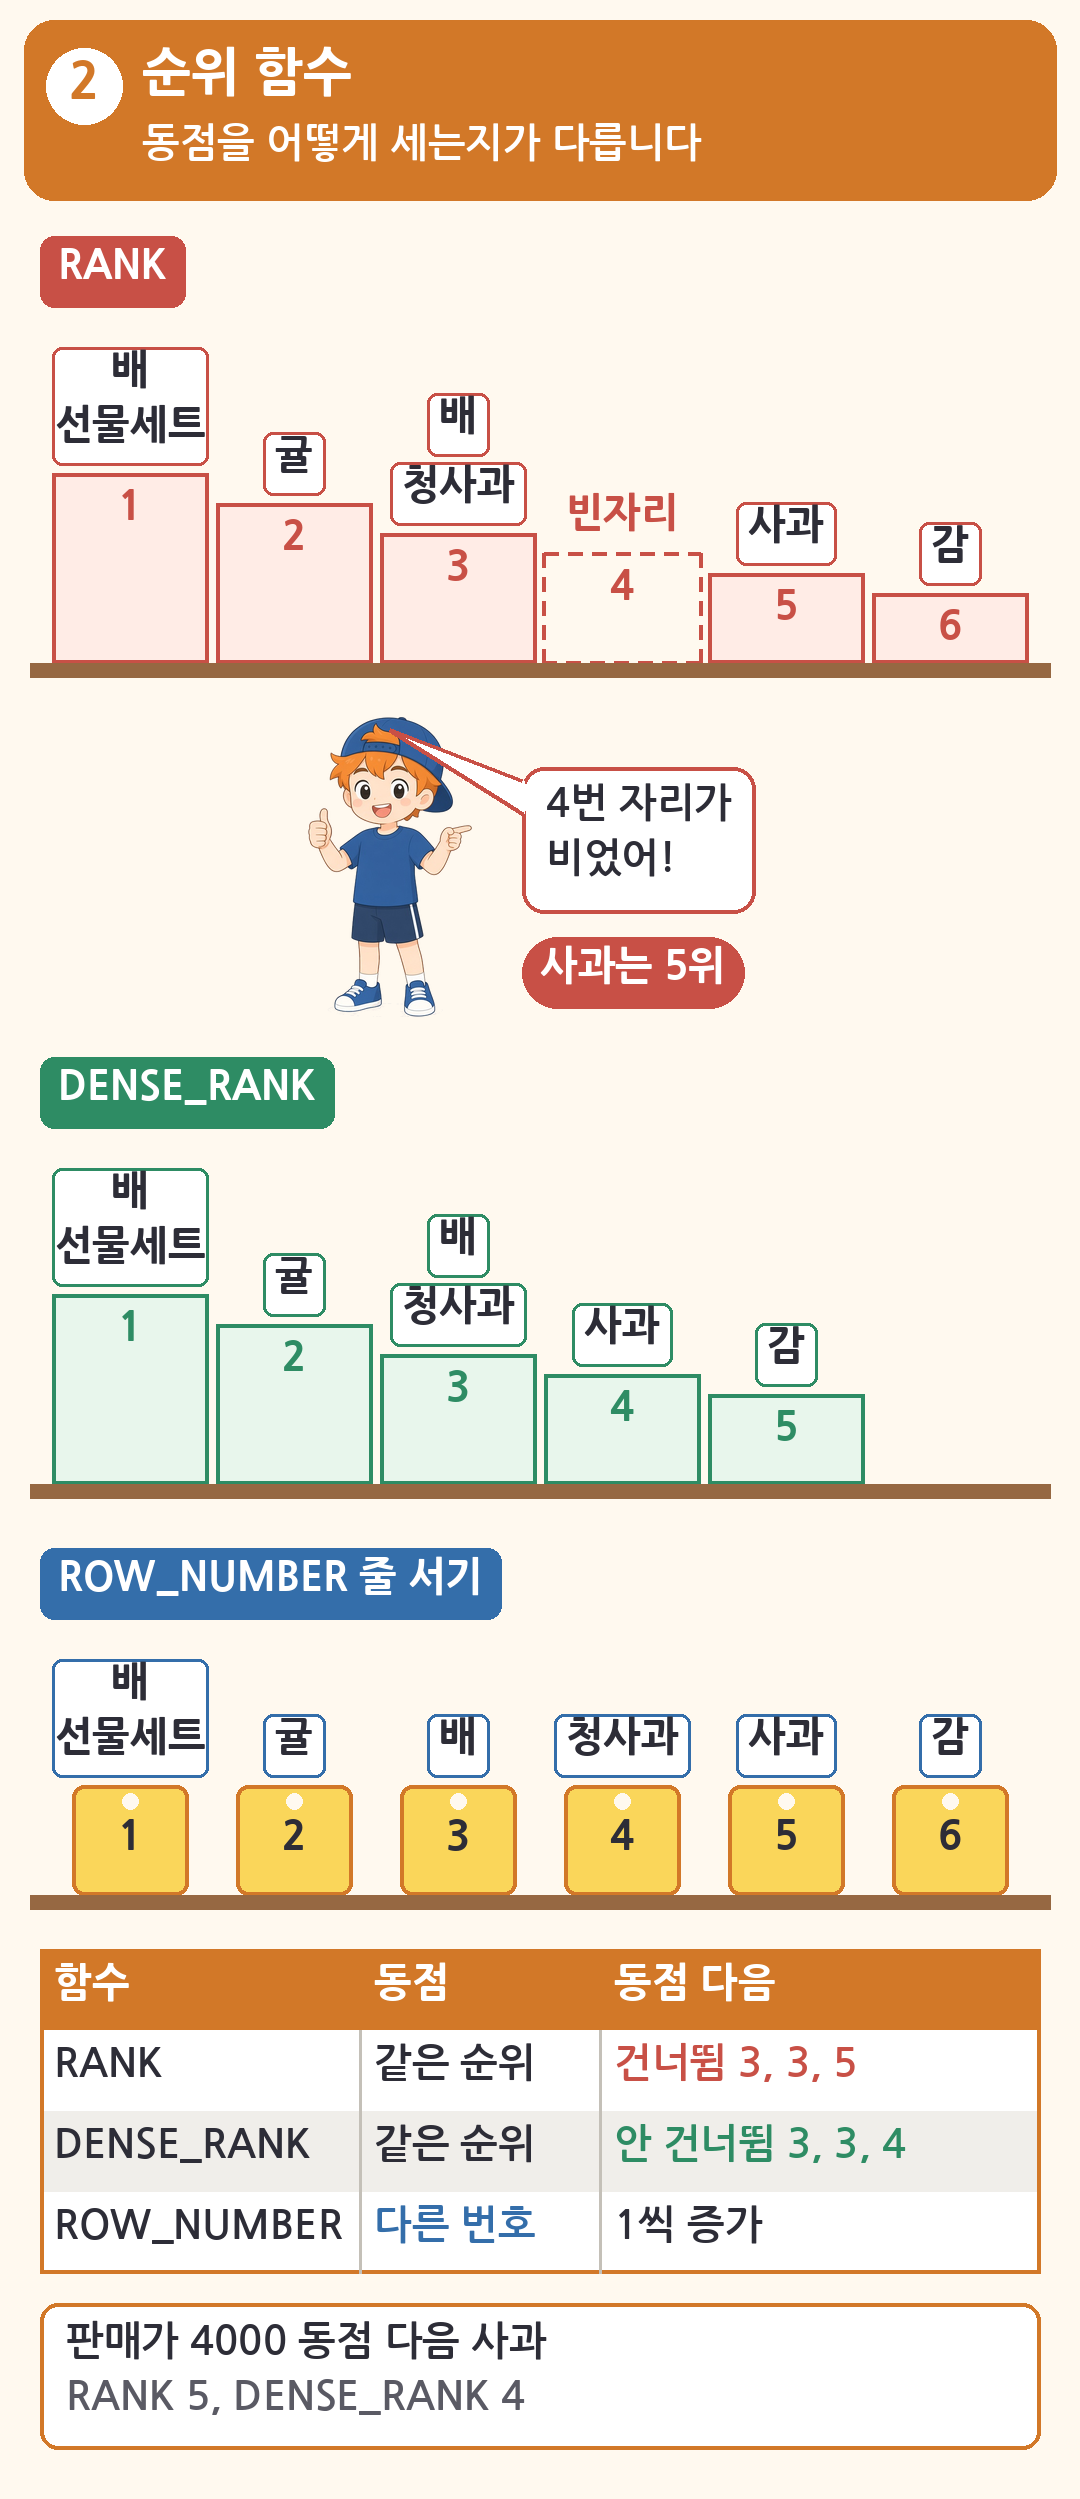
상품 판매가 내림차순 순위입니다.
SELECT 상품명, 판매가,
       RANK()       OVER (ORDER BY 판매가 DESC)           AS R,
       DENSE_RANK() OVER (ORDER BY 판매가 DESC)           AS DR,
       ROW_NUMBER() OVER (ORDER BY 판매가 DESC, 상품번호) AS RN
  FROM 상품
ORDER BY 판매가 DESC, 상품번호;| 상품(판매가) | R | DR | RN |
|---|---|---|---|
| 배 선물세트(25000) | 1 | 1 | 1 |
| 귤(5000) | 2 | 2 | 2 |
| 배(4000) | 3 | 3 | 3 |
| 청사과(4000) | 3 | 3 | 4 |
| 사과(3000) | 5 | 4 | 5 |
| 감(2000) | 6 | 5 | 6 |
| 함수 | 동점 | 동점 다음 순위 |
|---|---|---|
| RANK | 같은 순위 | 동점 수만큼 건너뜀(3, 3 다음 5) |
| DENSE_RANK | 같은 순위 | 건너뛰지 않음(3, 3 다음 4) |
| ROW_NUMBER | 다른 번호 | 항상 1씩 증가 |
- RANK는 올림픽 순위, DENSE_RANK는 빈틈없는 순위, ROW_NUMBER는 줄 번호라고 생각하면 쉽습니다.
- ROW_NUMBER는 동점끼리 누가 먼저 번호를 받을지 정해져 있지 않습니다. 결과를 고정하려면
ORDER BY 판매가 DESC, 상품번호처럼 정렬 기준을 하나 더 둡니다. 위 SQL의 RN은 그렇게 해서 배가 3, 청사과가 4입니다. - 주문금액 내림차순에서는 8000인 5005, 5006이 동점입니다. RANK는 4, 4 다음 6, DENSE_RANK는 4, 4 다음 5이고, 마지막 3000(5002)은 RANK 7, DENSE_RANK 6입니다.
3. PARTITION BY와 그룹별 1등
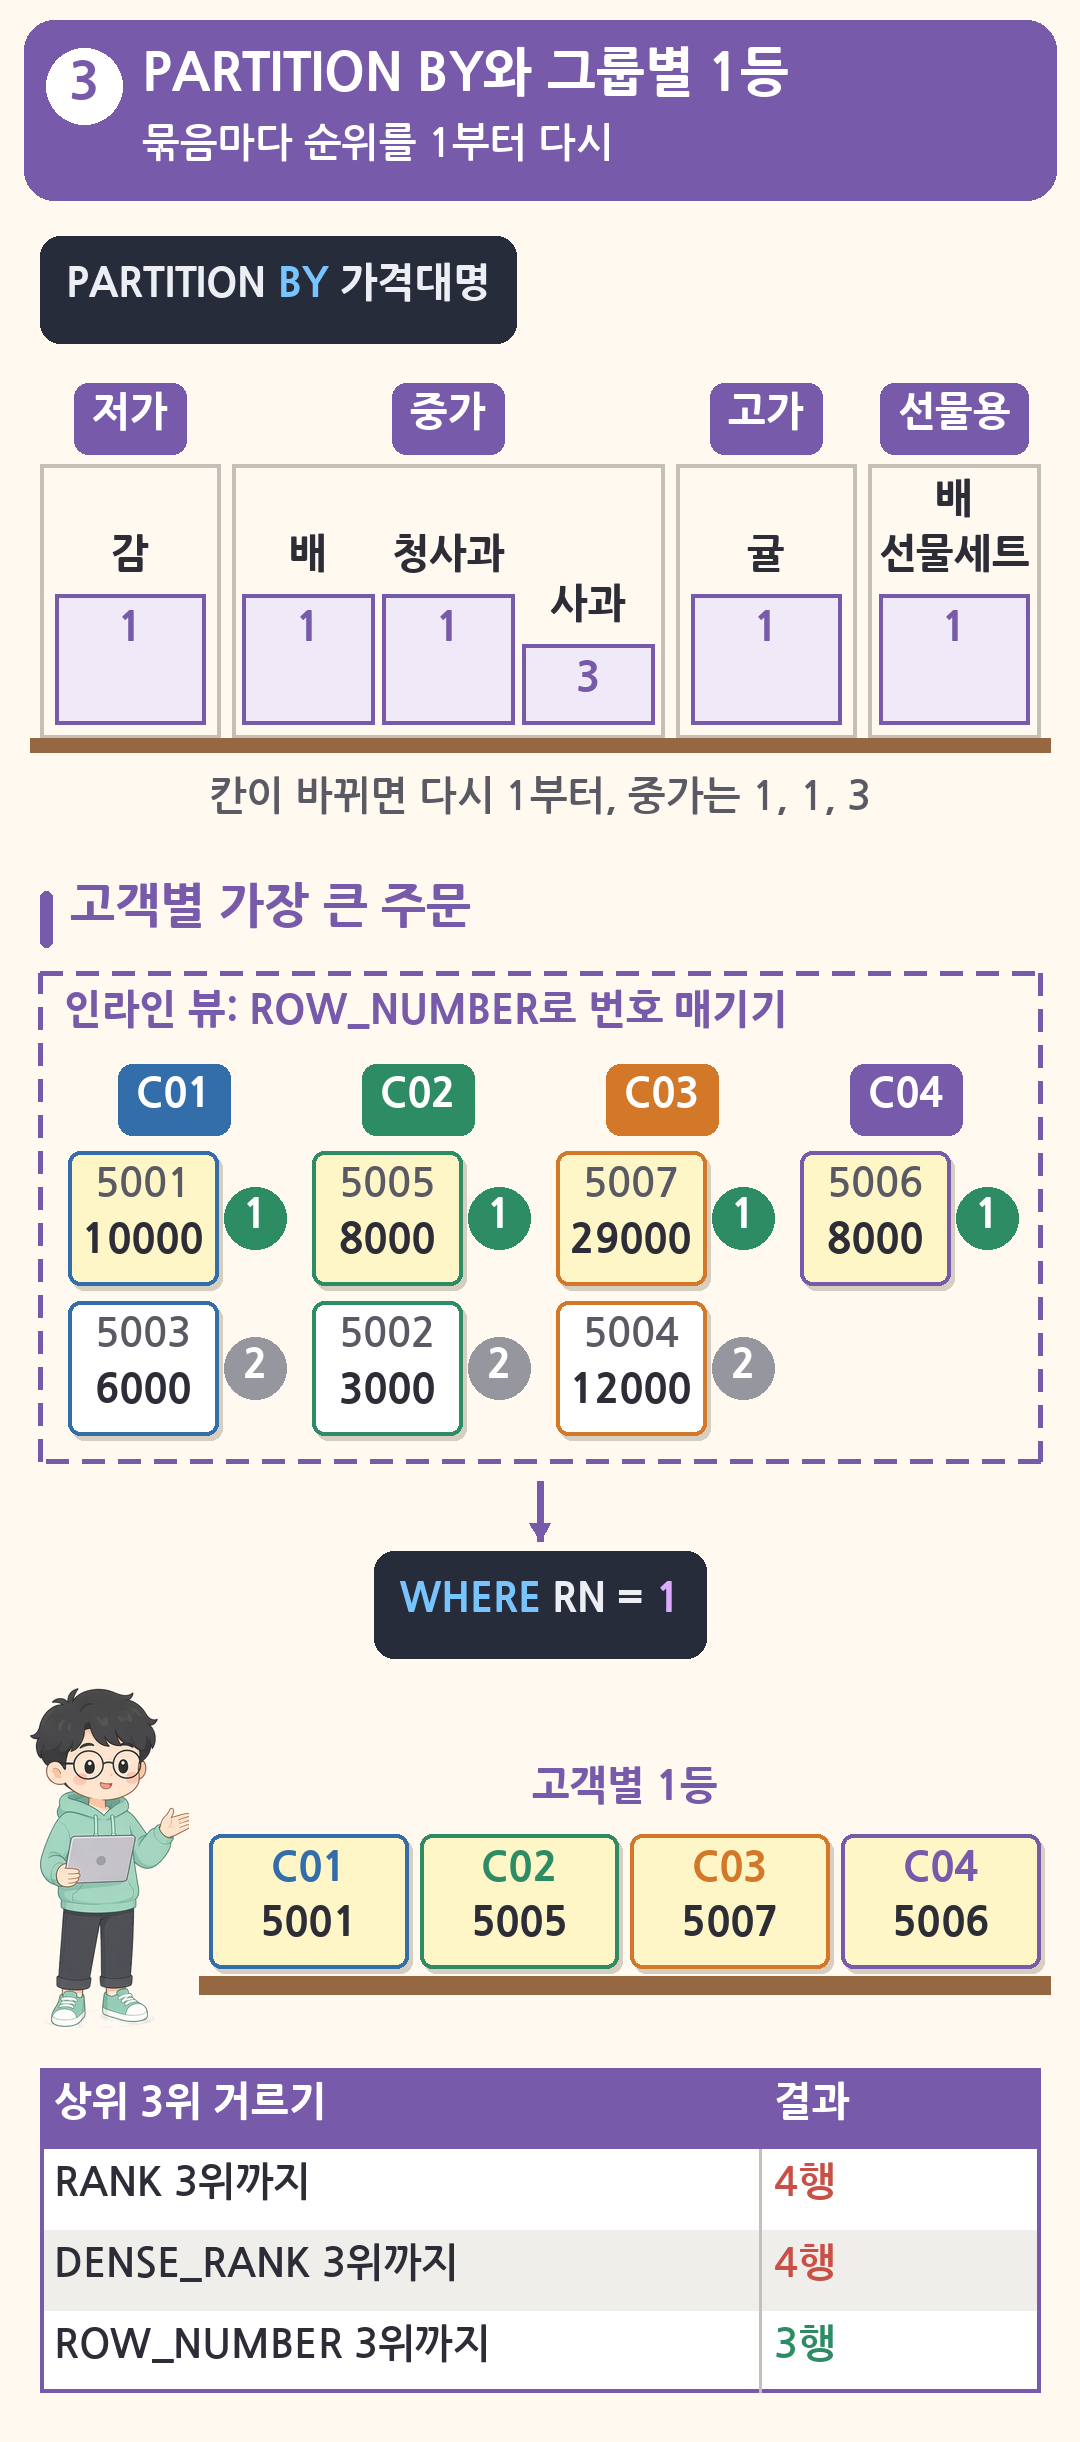
PARTITION BY를 쓰면 묶음마다 순위를 따로 매깁니다. 가격대 안에서의 판매가 순위입니다.
SELECT g.가격대명, p.상품명, p.판매가,
       RANK() OVER (PARTITION BY g.가격대명 ORDER BY p.판매가 DESC) AS 가격대내순위
  FROM 상품 p JOIN 가격대 g ON p.판매가 BETWEEN g.최저가 AND g.최고가
ORDER BY g.가격대명, 가격대내순위, p.상품번호;| 가격대명 | 상품명 | 판매가 | 가격대내순위 |
|---|---|---|---|
| 고가 | 귤 | 5000 | 1 |
| 선물용 | 배 선물세트 | 25000 | 1 |
| 저가 | 감 | 2000 | 1 |
| 중가 | 배 | 4000 | 1 |
| 중가 | 청사과 | 4000 | 1 |
| 중가 | 사과 | 3000 | 3 |
파티션이 바뀌면 순위가 1부터 다시 시작합니다. 중가 안에서도 RANK는 동점 두 개 다음을 3으로 건너뜁니다.
고객별 가장 큰 주문 찾기
윈도우 함수는 WHERE에 쓸 수 없으므로, 인라인 뷰 안에서 번호를 매기고 바깥 WHERE에서 거릅니다.
SELECT 고객번호, 주문번호, 주문금액
  FROM (SELECT 고객번호, 주문번호, 주문금액,
               ROW_NUMBER() OVER (PARTITION BY 고객번호
                                  ORDER BY 주문금액 DESC, 주문번호) AS RN
          FROM 금액)
WHERE RN = 1;| 고객번호 | 주문번호 | 주문금액 |
|---|---|---|
| C01 | 5001 | 10000 |
| C02 | 5005 | 8000 |
| C03 | 5007 | 29000 |
| C04 | 5006 | 8000 |
상위 3위 거르기와 Top N
판매가 순위를 인라인 뷰로 매기고 WHERE 순위 <= 3으로 거르면 함수에 따라 행 수가 다릅니다.
| 순위 함수 | 결과 |
|---|---|
| RANK ≤ 3 | 4행(배 선물세트, 귤, 배, 청사과) |
| DENSE_RANK ≤ 3 | 4행(같은 네 상품) |
| ROW_NUMBER ≤ 3 | 3행 |
「WHERE 절과 ORDER BY, Top N 쿼리」에서 본 FETCH FIRST 3 ROWS WITH TIES(4행)는 RANK ≤ 3과, FETCH FIRST 3 ROWS ONLY(3행)는 ROW_NUMBER ≤ 3과 같은 결과입니다.
4. 집계 윈도우 함수와 누적합
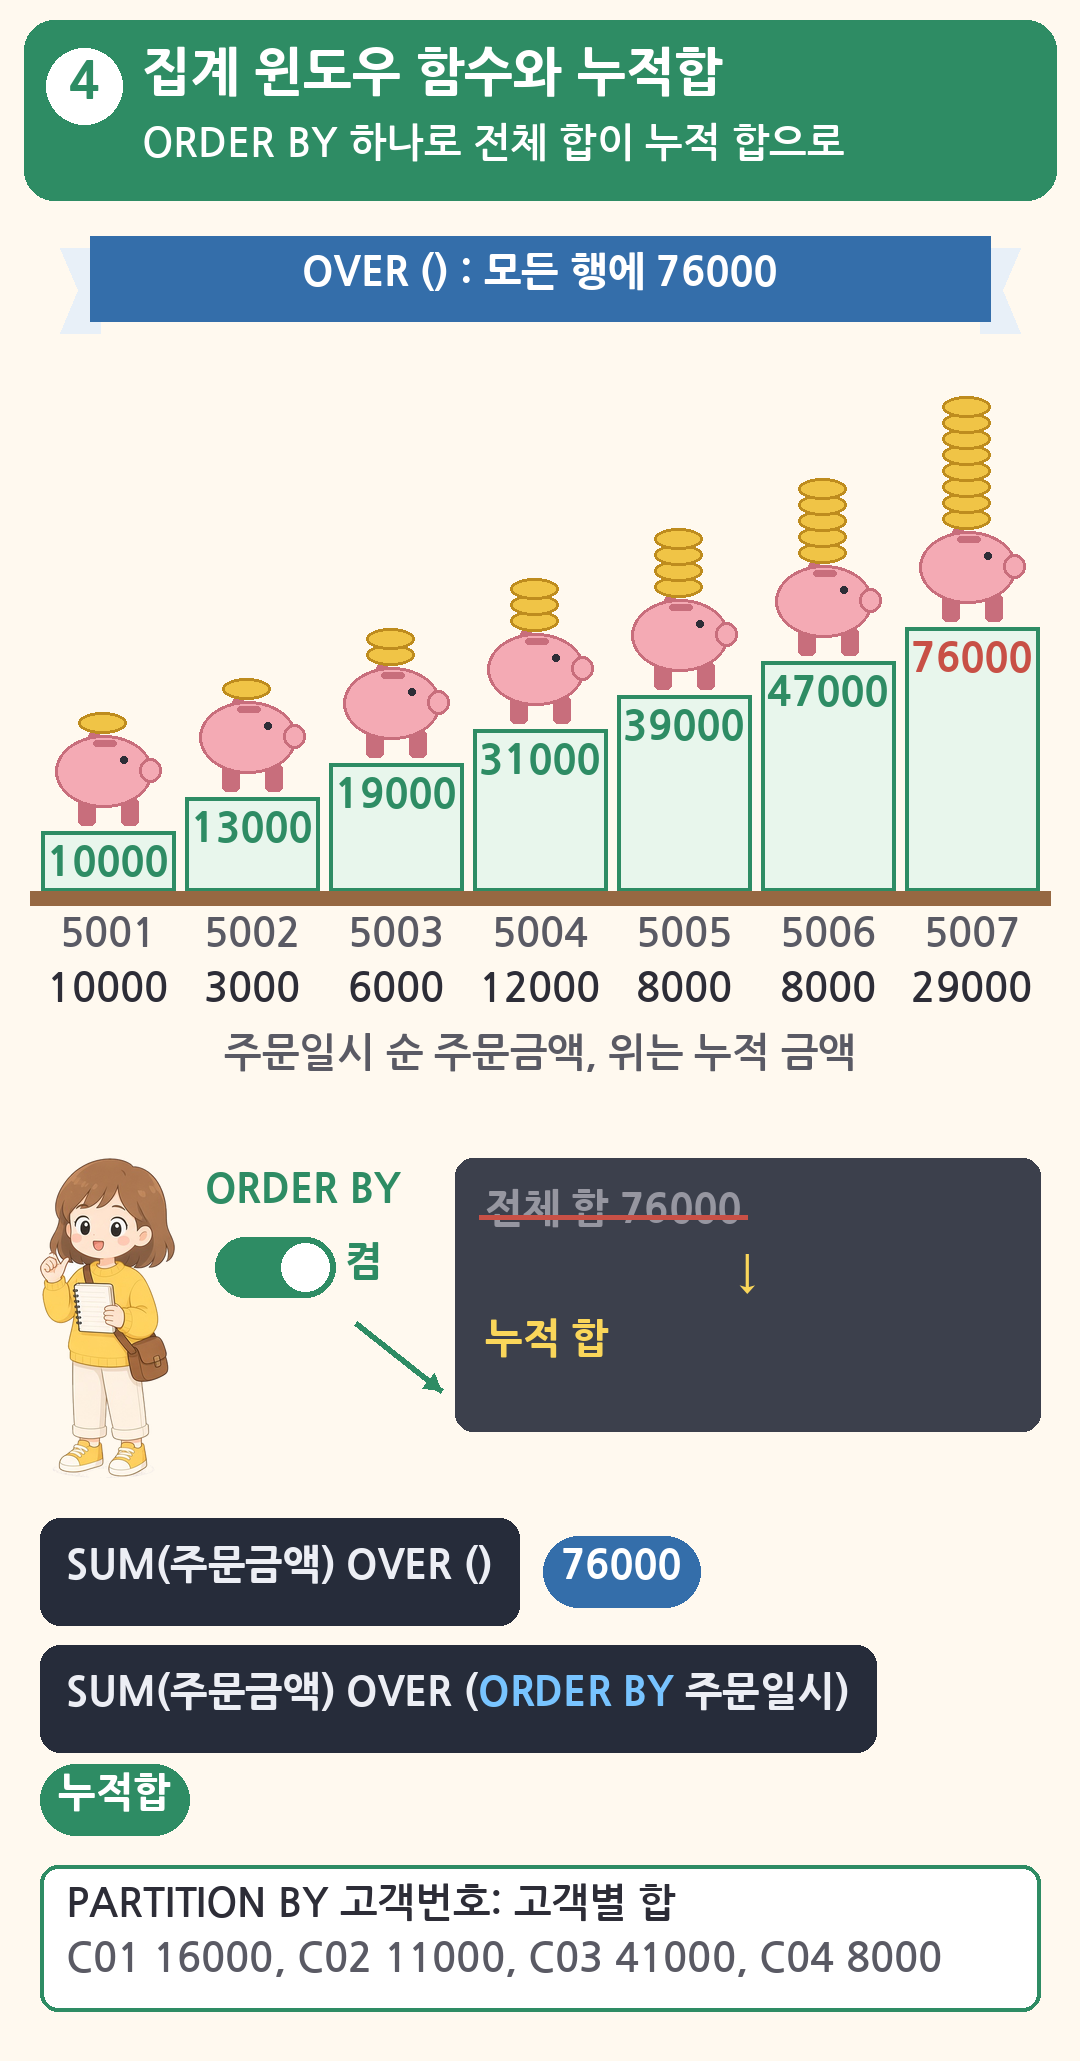
SUM, COUNT 같은 집계 함수에 OVER를 붙이면 행을 줄이지 않고 집계값을 행마다 붙입니다.
SELECT 주문번호, 고객번호, 주문금액,
       SUM(주문금액) OVER ()                      AS 전체합,
       SUM(주문금액) OVER (PARTITION BY 고객번호) AS 고객합,
       COUNT(*)     OVER (PARTITION BY 고객번호) AS 고객건수,
       SUM(주문금액) OVER (ORDER BY 주문일시)     AS 누적
  FROM 금액
ORDER BY 주문일시;| 주문(고객) | 주문금액 | 고객합 | 누적 |
|---|---|---|---|
| 5001(C01) | 10000 | 16000 | 10000 |
| 5002(C02) | 3000 | 11000 | 13000 |
| 5003(C01) | 6000 | 16000 | 19000 |
| 5004(C03) | 12000 | 41000 | 31000 |
| 5005(C02) | 8000 | 11000 | 39000 |
| 5006(C04) | 8000 | 8000 | 47000 |
| 5007(C03) | 29000 | 41000 | 76000 |
OVER (): 파티션도 정렬도 없으므로 전체 합계 76000이 7행 모두에 붙습니다.OVER (PARTITION BY 고객번호): 고객별 합이 그 고객의 모든 행에 붙습니다. C03 41000, C01 16000, C02 11000, C04 8000은 「조인 기초, 등가 조인과 오라클 (+) 표기」의 고객별 구매금액과 같습니다. 고객건수는 C04만 1이고 나머지는 2입니다.OVER (ORDER BY 주문일시): ORDER BY가 생기면 윈도우 절 기본값(처음부터 현재 행까지)이 적용되어 누적합이 됩니다. ORDER BY 하나로 「전체 합」이 「누적 합」으로 바뀌는 것이 시험 포인트입니다.COUNT(이메일) OVER (PARTITION BY 등급코드)처럼 컬럼을 세면 NULL은 빠집니다. G 등급 2명 중 이메일이 있는 사람은 1명이라 G 등급 행에는 1이 붙습니다.
GROUP BY 결과에 윈도우 함수 쓰기
집계 함수를 윈도우 함수 안에 넣을 수 있습니다. 등급별 판매금액과 전체 중 비중입니다.
SELECT c.등급코드, SUM(oi.주문수량 * oi.주문단가) AS 판매금액,
       ROUND(SUM(oi.주문수량 * oi.주문단가)
             / SUM(SUM(oi.주문수량 * oi.주문단가)) OVER () * 100, 1) AS 비중
  FROM 주문상품 oi JOIN 주문 o ON oi.주문번호 = o.주문번호
                   JOIN 고객 c ON o.고객번호 = c.고객번호
GROUP BY c.등급코드;| 등급코드 | 판매금액 | 비중(%) |
|---|---|---|
| B | 41000 | 53.9 |
| G | 24000 | 31.6 |
| S | 11000 | 14.5 |
- 판매금액은 「집합 연산자와 ROLLUP·CUBE·GROUPING SETS」의 등급 소계와 같습니다. GROUP BY가 먼저 끝난 뒤 윈도우 함수가 계산되므로
SUM(SUM(...)) OVER ()가 됩니다. - 반대로 윈도우 함수 안에 윈도우 함수를 넣는
SUM(RANK() OVER (...)) OVER ()는 오류(ORA-30483)입니다. 윈도우 함수끼리는 중첩할 수 없고, 필요하면 인라인 뷰로 나눕니다.
5. 윈도우 절: ROWS와 RANGE
| 표현 | 뜻 |
|---|---|
| UNBOUNDED PRECEDING | 파티션의 첫 행 |
| n PRECEDING | 현재 행보다 n만큼 앞(ROWS는 n행, RANGE는 값 n) |
| CURRENT ROW | 현재 행(RANGE에서는 정렬 값이 같은 행 전부) |
| n FOLLOWING | 현재 행보다 n만큼 뒤 |
| UNBOUNDED FOLLOWING | 파티션의 마지막 행 |
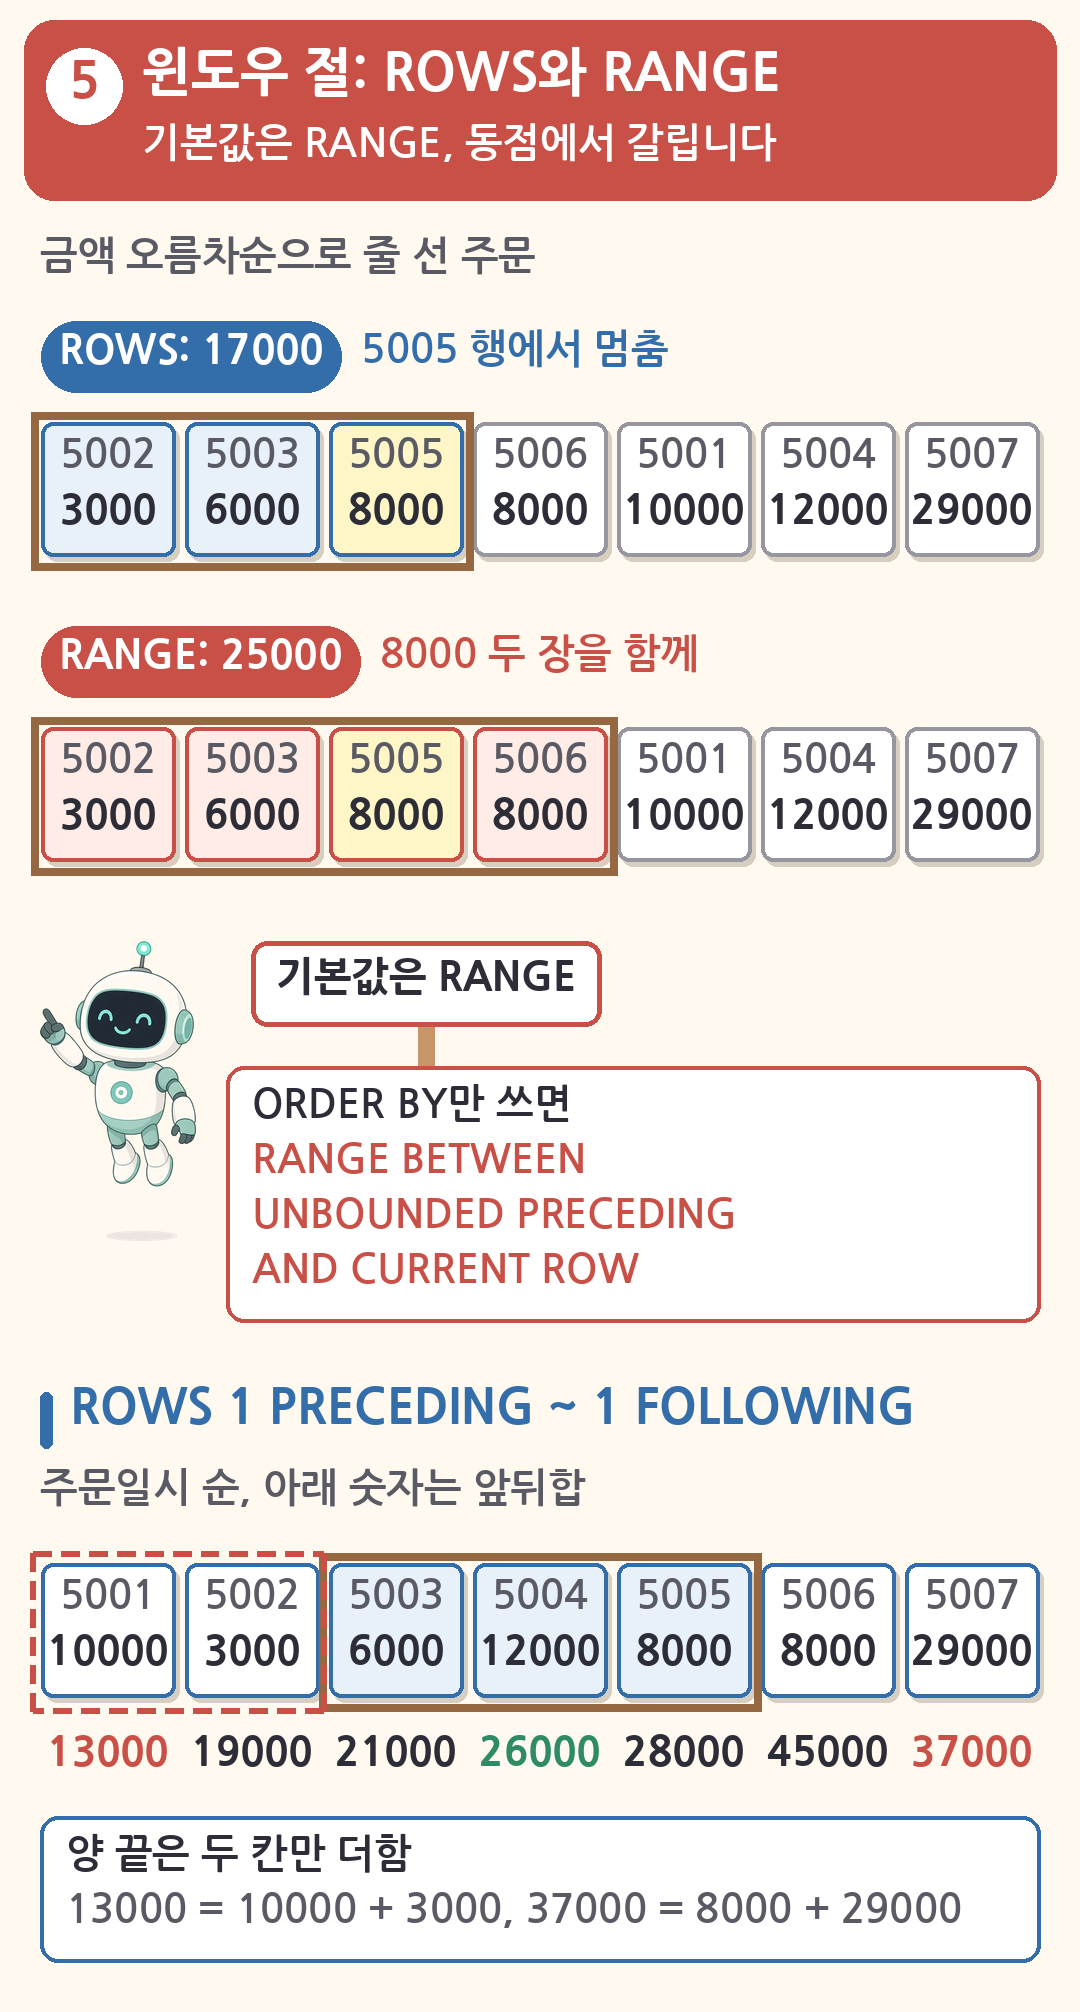
- ROWS는 물리적인 행 개수로, RANGE는 ORDER BY 값의 논리적 범위로 윈도우를 정합니다.
ROWS UNBOUNDED PRECEDING은ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW를 줄인 표현입니다.- 기본값: OVER에 ORDER BY만 쓰고 윈도우 절을 생략하면
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW입니다. ROWS가 아니라 RANGE입니다.
동점에서 RANGE와 ROWS가 갈립니다
주문금액 오름차순 누적합을 기본값(RANGE)과 ROWS로 비교합니다.
SELECT 주문번호, 주문금액,
       SUM(주문금액) OVER (ORDER BY 주문금액) AS 기본,
       SUM(주문금액) OVER (ORDER BY 주문금액
                           ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS 행기준
FROM 금액;| 주문번호 | 주문금액 | 기본(RANGE) | 행기준(ROWS) |
|---|---|---|---|
| 5002 | 3000 | 3000 | 3000 |
| 5003 | 6000 | 9000 | 9000 |
| 5005 | 8000 | 25000 | 17000 |
| 5006 | 8000 | 25000 | 25000 |
| 5001 | 10000 | 35000 | 35000 |
| 5004 | 12000 | 47000 | 47000 |
| 5007 | 29000 | 76000 | 76000 |
- RANGE의 CURRENT ROW는 「값이 8000인 행까지」라서 5005 행에서도 5006의 8000이 함께 더해져 25000입니다. ROWS는 「이 행까지」라 17000입니다.
- 동점이 없으면 두 결과가 같아서 차이를 모르고 지나가기 쉽습니다. 상품 판매가 내림차순 누적도 4000 두 개에서 RANGE는 38000, 38000, ROWS는 34000, 38000입니다.
이동 합계와 이동 평균(ROWS)
SELECT 주문번호, 주문금액,
       SUM(주문금액) OVER (ORDER BY 주문일시
                           ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING) AS 앞뒤합,
       ROUND(AVG(주문금액) OVER (ORDER BY 주문일시
                           ROWS BETWEEN 2 PRECEDING AND CURRENT ROW)) AS 최근3평균
FROM 금액;| 주문번호 | 주문금액 | 앞뒤합 | 최근3평균 |
|---|---|---|---|
| 5001 | 10000 | 13000 | 10000 |
| 5002 | 3000 | 19000 | 6500 |
| 5003 | 6000 | 21000 | 6333 |
| 5004 | 12000 | 26000 | 7000 |
| 5005 | 8000 | 28000 | 8667 |
| 5006 | 8000 | 45000 | 9333 |
| 5007 | 29000 | 37000 | 15000 |
첫 행과 마지막 행은 앞이나 뒤 행이 없어 두 행만 더합니다(13000 = 10000 + 3000, 37000 = 8000 + 29000). 평균도 처음 두 행은 1건, 2건으로 나눕니다.
RANGE에 값 범위 쓰기
SELECT 주문번호, 주문금액,
       COUNT(*) OVER (ORDER BY 주문금액
                      RANGE BETWEEN 2000 PRECEDING AND 2000 FOLLOWING) AS 건수
FROM 금액;| 주문번호 | 주문금액 | 건수(±2000 안) |
|---|---|---|
| 5002 | 3000 | 1 |
| 5003 | 6000 | 3(6000, 8000, 8000) |
| 5005 | 8000 | 4(6000 ~ 10000) |
| 5006 | 8000 | 4 |
| 5001 | 10000 | 4(8000, 8000, 10000, 12000) |
| 5004 | 12000 | 2 |
| 5007 | 29000 | 1 |
- RANGE의 n은 행 수가 아니라 값의 차이입니다. 날짜로 정렬하면 n은 「n일」이라,
ORDER BY 주문일시 RANGE BETWEEN 2 PRECEDING AND CURRENT ROW는 현재 주문 시각부터 48시간 전까지의 합입니다. 5004 행은 5002(10-02 14:30)가 48시간 밖이라 6000 + 12000 = 18000입니다. - RANGE에 값 범위를 쓰려면 ORDER BY 컬럼이 하나여야 합니다. 두 개면 오류(ORA-30486)입니다.
6. 행 순서 함수: FIRST_VALUE, LAST_VALUE, LAG, LEAD
LAST_VALUE의 기본 범위 함정
SELECT 상품번호, 판매가,
       FIRST_VALUE(상품명) OVER (ORDER BY 판매가 DESC, 상품번호) AS 첫값,
       LAST_VALUE(상품명)  OVER (ORDER BY 판매가 DESC, 상품번호) AS 끝값_기본,
       LAST_VALUE(상품명)  OVER (ORDER BY 판매가 DESC, 상품번호
                                 ROWS BETWEEN UNBOUNDED PRECEDING
                                          AND UNBOUNDED FOLLOWING) AS 끝값_전체
FROM 상품;| 상품번호 | 첫값 | 끝값_기본 | 끝값_전체 |
|---|---|---|---|
| P60 | 배 선물세트 | 배 선물세트 | 감 |
| P40 | 배 선물세트 | 귤 | 감 |
| P20 | 배 선물세트 | 배 | 감 |
| P50 | 배 선물세트 | 청사과 | 감 |
| P10 | 배 선물세트 | 사과 | 감 |
| P30 | 배 선물세트 | 감 | 감 |
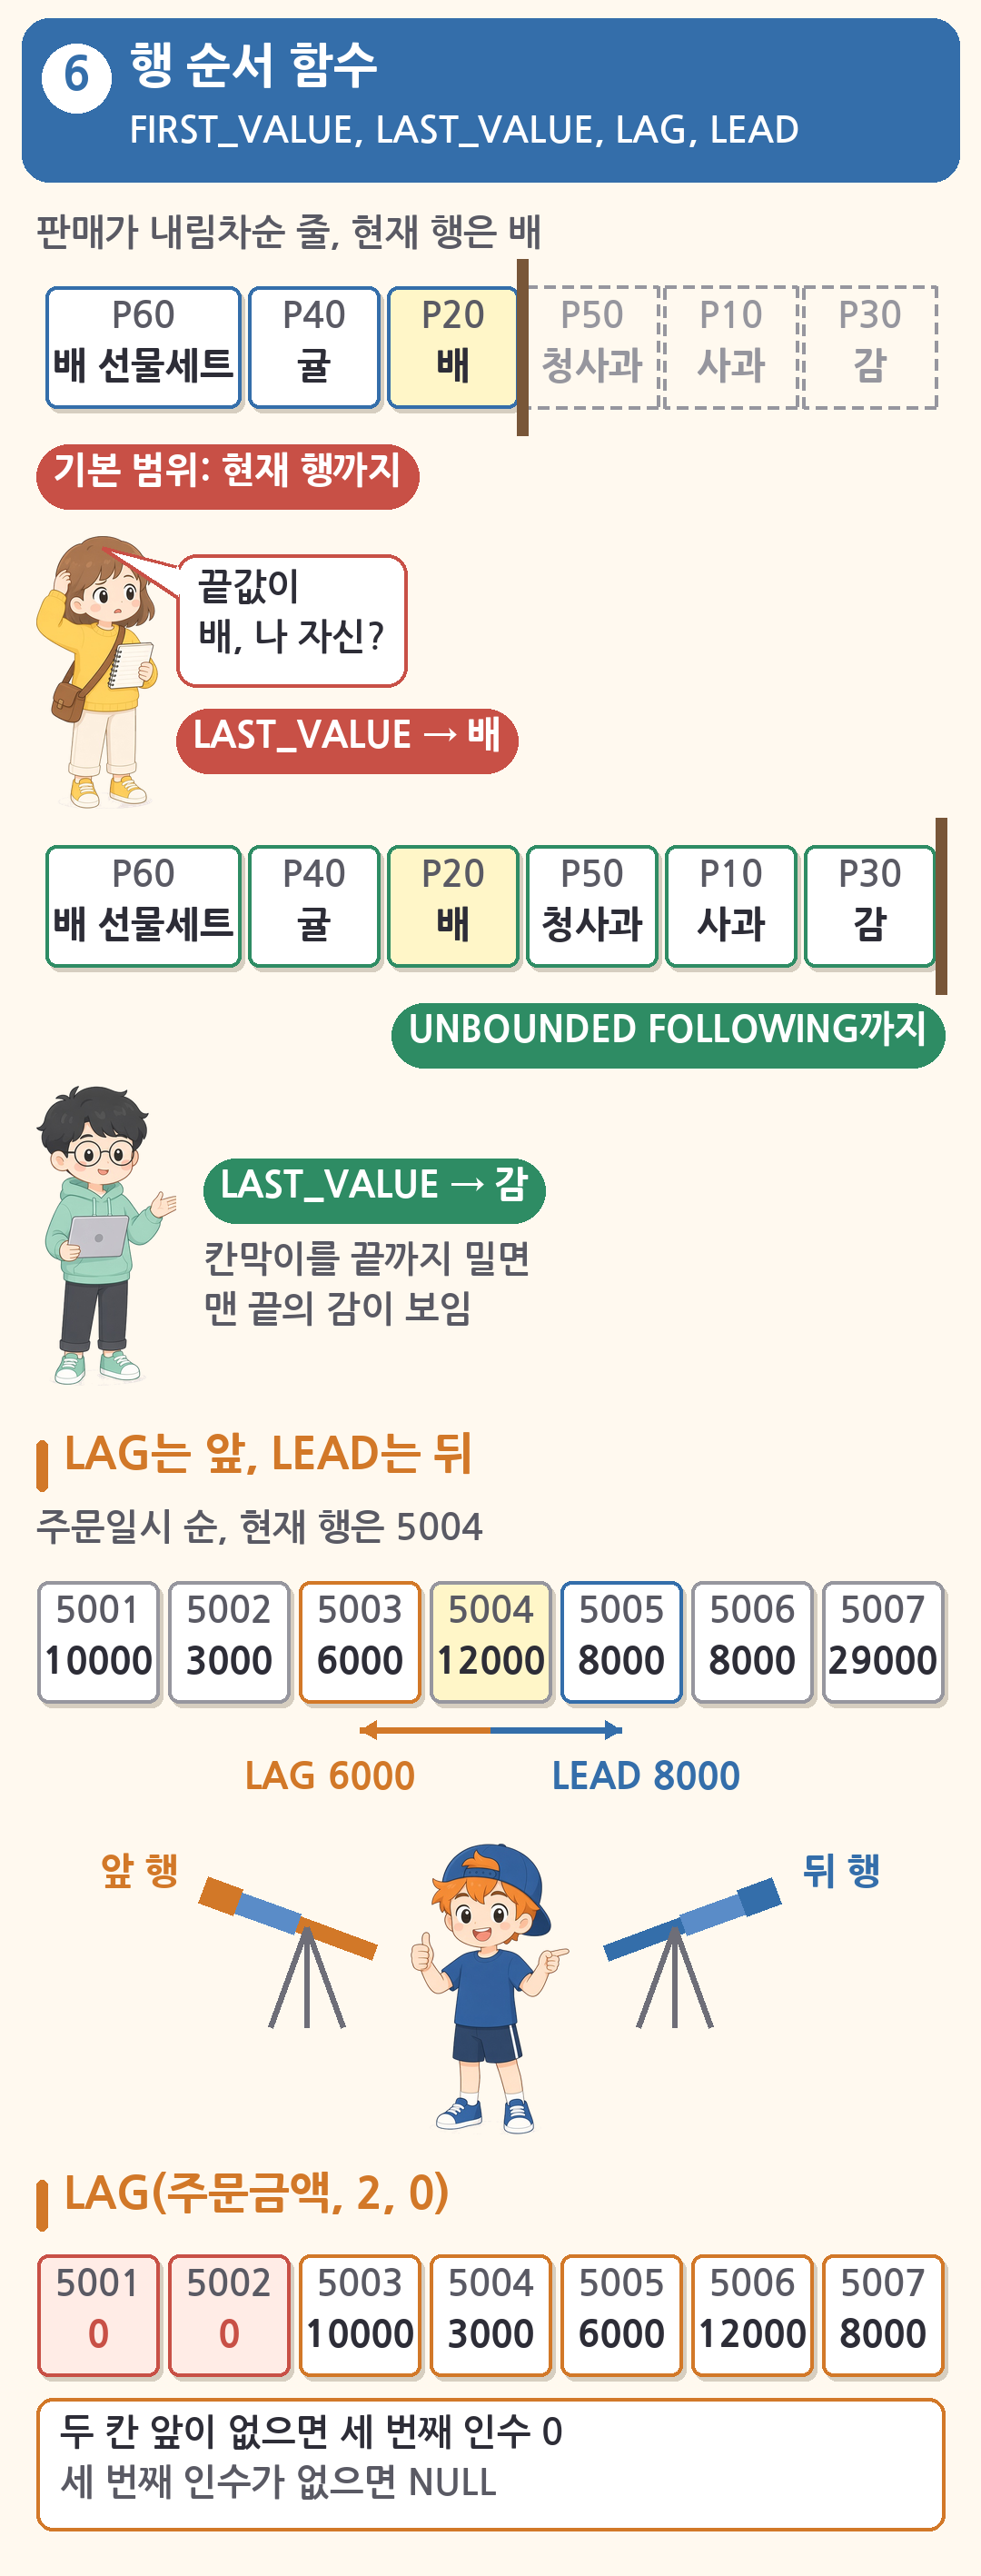
- 기본 범위가 「처음부터 현재 행까지」라서 LAST_VALUE는 현재 행 자신이 됩니다. 파티션 전체의 마지막 값을 원하면 범위를
UNBOUNDED FOLLOWING까지 늘립니다. - FIRST_VALUE는 기본 범위에서도 첫 행이 들어 있으므로 늘 배 선물세트입니다.
- 정렬 기준에 동점이 있으면(
ORDER BY 판매가 DESC만 쓰면) RANGE 기본 범위가 동점 끝까지라, 배(P20) 행의LAST_VALUE(상품번호)는 P20이 아니라 P50입니다.
LAG와 LEAD
LAG(컬럼, n, 기본값)은 n행 앞, LEAD(컬럼, n, 기본값)은 n행 뒤의 값입니다. n을 생략하면 1이고, 해당하는 행이 없으면 기본값을, 기본값도 생략하면 NULL을 돌려줍니다.
SELECT 주문번호, 주문금액,
       LAG(주문금액)        OVER (ORDER BY 주문일시) AS 이전,
       LEAD(주문금액)       OVER (ORDER BY 주문일시) AS 다음,
       LAG(주문금액, 2, 0)  OVER (ORDER BY 주문일시) AS 두행전
FROM 금액;| 주문(금액) | 이전 | 다음 | 두행전 |
|---|---|---|---|
| 5001(10000) | NULL | 3000 | 0 |
| 5002(3000) | 10000 | 6000 | 0 |
| 5003(6000) | 3000 | 12000 | 10000 |
| 5004(12000) | 6000 | 8000 | 3000 |
| 5005(8000) | 12000 | 8000 | 6000 |
| 5006(8000) | 8000 | 29000 | 12000 |
| 5007(29000) | 8000 | NULL | 8000 |
- 두행전은 세 번째 인수 0 덕분에 앞 두 행이 NULL이 아니라 0입니다.
PARTITION BY 고객번호를 더하면 고객별 「직전 주문」이 됩니다. C01의 5003은 5001(10000), C02의 5005는 5002(3000), C03의 5007은 5004(12000)를 가리키고, 각 고객의 첫 주문과 주문이 하나뿐인 C04의 5006은 NULL입니다.- 순위 함수와 LAG·LEAD, ROWS·RANGE 윈도우 절은 OVER 안에 ORDER BY가 꼭 있어야 합니다.
7. 비율 함수: RATIO_TO_REPORT, PERCENT_RANK, CUME_DIST, NTILE
| 함수 | 계산 | 값의 범위와 특징 |
|---|---|---|
| RATIO_TO_REPORT(컬럼) | 값 ÷ 파티션 합계 | 0 ~ 1, 모두 더하면 1. OVER 안에 ORDER BY를 쓰면 오류(ORA-30487) |
| PERCENT_RANK() | (RANK - 1) ÷ (행 수 - 1) | 첫 행 0, 마지막 행 1 |
| CUME_DIST() | 현재 값 이하인 행 수 ÷ 행 수 | 0보다 크고 1 이하 |
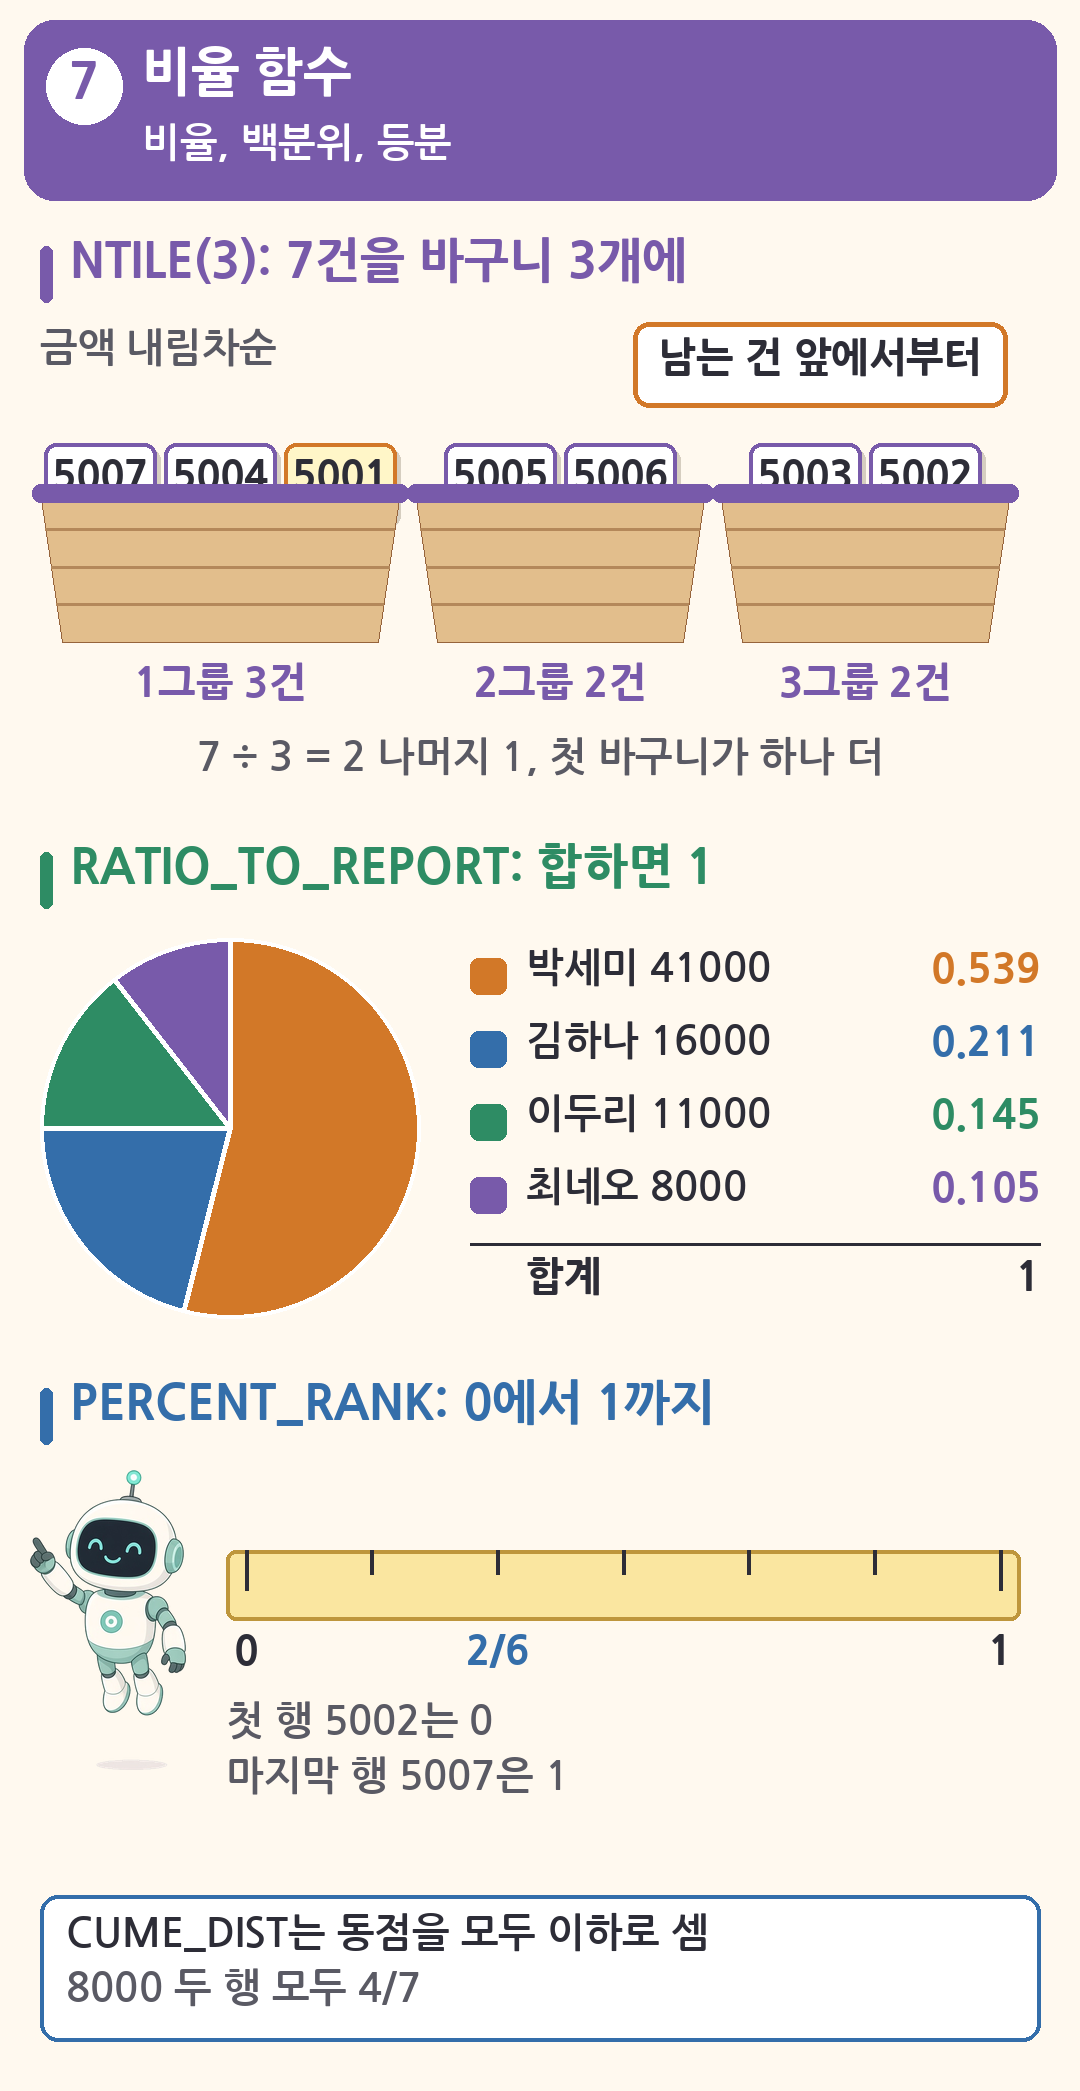
| NTILE(n) | 정렬된 행을 n개 묶음으로 나눈 번호 | 묶음 크기 차이는 최대 1, 남는 행은 앞 묶음부터 |
RATIO_TO_REPORT
고객별 구매금액에 RATIO_TO_REPORT(구매금액) OVER ()를 붙이면 박세미 41000은 0.539, 김하나 16000은 0.211, 이두리 11000은 0.145, 최네오 8000은 0.105이고, 네 값을 더하면 1입니다. 구매금액 / SUM(구매금액) OVER ()와 같은 값입니다.
PERCENT_RANK와 CUME_DIST
SELECT 주문번호, 주문금액,
       RANK()         OVER (ORDER BY 주문금액) AS R,
       PERCENT_RANK() OVER (ORDER BY 주문금액) AS PR,
       CUME_DIST()    OVER (ORDER BY 주문금액) AS CD
FROM 금액;| 주문(금액) | R | PR | CD |
|---|---|---|---|
| 5002(3000) | 1 | 0 | 1/7 |
| 5003(6000) | 2 | 1/6 | 2/7 |
| 5005(8000) | 3 | 2/6 | 4/7 |
| 5006(8000) | 3 | 2/6 | 4/7 |
| 5001(10000) | 5 | 4/6 | 5/7 |
| 5004(12000) | 6 | 5/6 | 6/7 |
| 5007(29000) | 7 | 1 | 1 |
- 결과는 소수(0.167, 0.571 등)로 나오지만 계산을 보이려고 분수로 적었습니다.
- PERCENT_RANK는 RANK에서 1을 빼고 (행 수 - 1) = 6으로 나눕니다. 첫 행은 0, 마지막 행은 1입니다.
- CUME_DIST는 동점 행을 모두 「이하」로 세므로 8000 두 행이 모두 4/7입니다.
NTILE
| 대상 | 결과 |
|---|---|
주문 7건, NTILE(3), 금액 내림차순 |
1그룹 3건(5007, 5004, 5001), 2그룹 2건(5005, 5006), 3그룹 2건(5003, 5002) |
상품 6개, NTILE(4), 판매가 내림차순 |
1그룹 P60, P40 / 2그룹 P20, P50 / 3그룹 P10 / 4그룹 P30 |
상품 6개, NTILE(3) |
2개, 2개, 2개 |
- 7 ÷ 3 = 2 나머지 1이라 첫 묶음만 하나 더 받아 3, 2, 2입니다. 6 ÷ 4 = 1 나머지 2라 앞 두 묶음이 2개씩, 2, 2, 1, 1입니다.
- NTILE은 값이 아니라 행 개수로 나누므로 동점이라도 다른 묶음에 들어갈 수 있습니다.
8. SQL Server와의 차이

| 항목 | 오라클 | SQL Server |
|---|---|---|
| RATIO_TO_REPORT | 지원 | 없음. x / SUM(x) OVER ()로 바꿔 씀 |
RANGE 값 범위(RANGE BETWEEN 2000 PRECEDING ...) |
지원 | UNBOUNDED와 CURRENT ROW만 가능 |
| 순위, LAG·LEAD, FIRST_VALUE·LAST_VALUE, PERCENT_RANK, CUME_DIST, NTILE | 지원 | 지원, 같은 데이터면 결과도 같음 |
| ORDER BY만 쓸 때 기본 윈도우 | RANGE, 처음부터 현재 행까지 | 같음 |
| WHERE에 윈도우 함수 | 오류 | 오류 |
일부 정리 자료에는 「SQL Server는 LAG·LEAD, PERCENT_RANK, 윈도우 절을 지원하지 않는다」는 옛 내용이 남아 있습니다. 지금 SQL Server는 모두 지원하므로, 시험 보기에서 SQL Server에 없는 함수로 확실히 고를 수 있는 것은 RATIO_TO_REPORT입니다.
9. 헷갈리기 쉬운 점
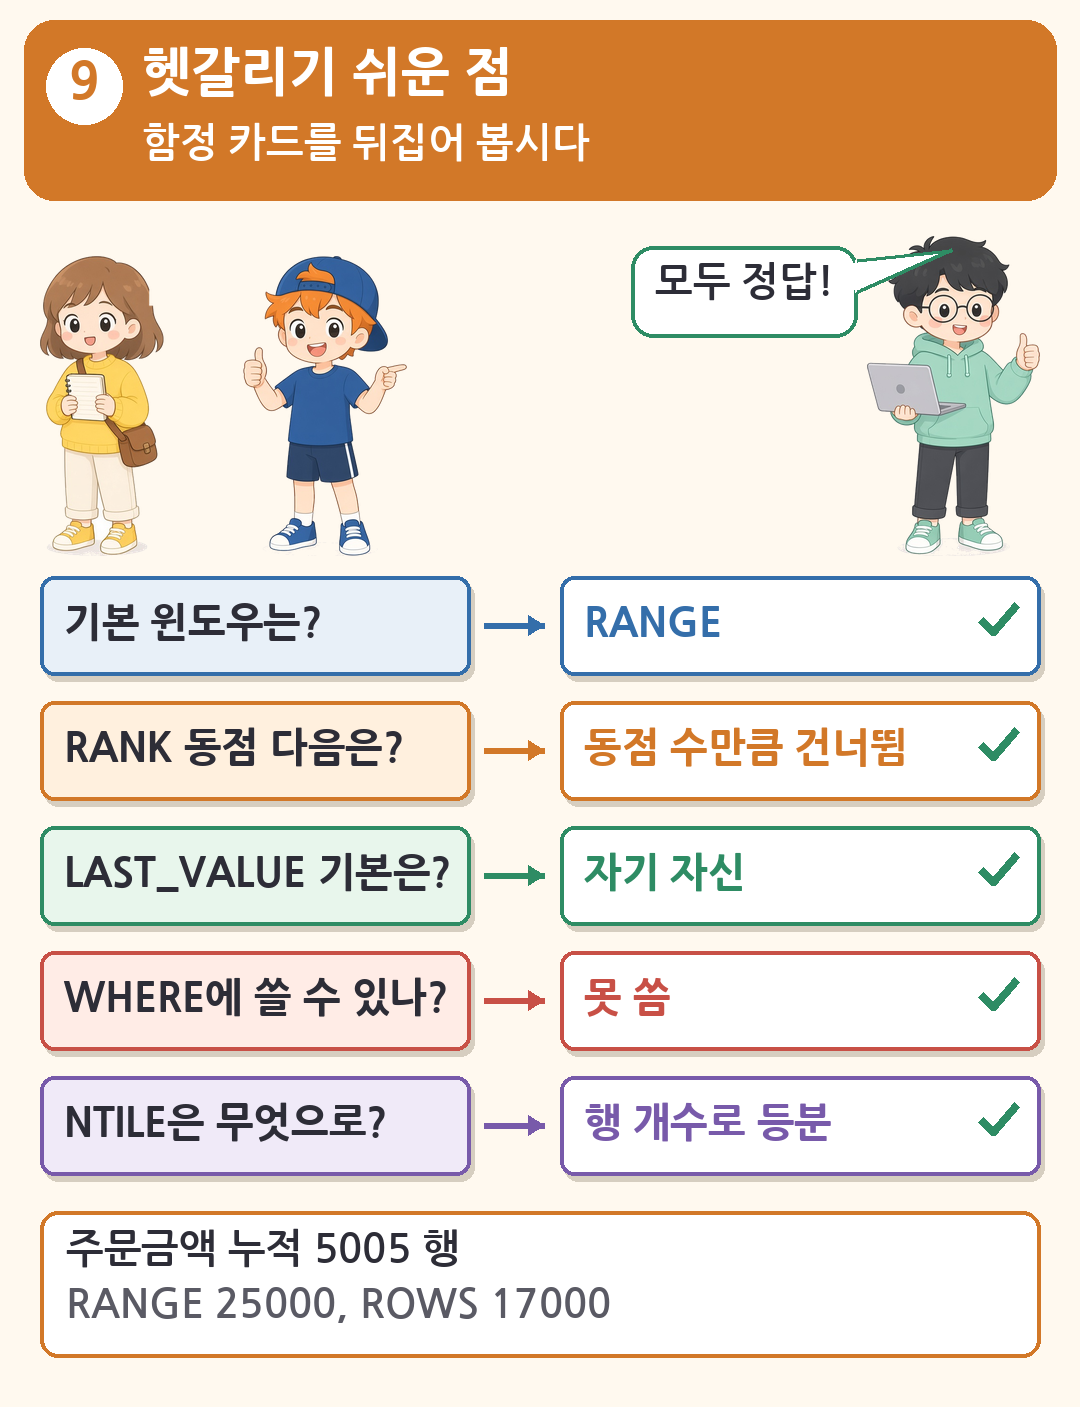
- 기본 윈도우는 ROWS가 아니라 RANGE입니다. 동점 행에서만 결과가 갈립니다. 주문금액 누적에서 5005 행은 RANGE 25000, ROWS 17000입니다.
- RANK의 건너뜀은 동점 수만큼입니다. 3위가 2명이면 다음은 5위, 3명이면 6위입니다. DENSE_RANK는 언제나 바로 다음 숫자입니다.
- ORDER BY 하나로 집계 결과가 바뀝니다.
SUM(x) OVER (PARTITION BY a)는 파티션 전체 합,SUM(x) OVER (PARTITION BY a ORDER BY b)는 파티션 안 누적 합입니다. - LAST_VALUE는 기본 범위에서 자기 자신입니다. 「마지막 값」이라는 이름에 속지 말고 윈도우 절을 확인합니다.
- 윈도우 함수는 WHERE, GROUP BY, HAVING에 쓸 수 없습니다. 순위로 거르려면 인라인 뷰를 씁니다.
- 윈도우 함수 별칭은 같은 SELECT에서 다시 쓸 수 없습니다.
RANK() OVER (...) AS 순위, 순위 + 1은 오류(ORA-00904)입니다. ORDER BY에는 별칭을 쓸 수 있습니다. - ROW_NUMBER의 동점 순서는 보장되지 않습니다. 보기에서 동점끼리 번호가 정해져 있으면 ORDER BY에 두 번째 기준이 있는지 봅니다.
- NTILE은 행 수로 나눕니다. 7건을 3묶음으로 나누면 3, 2, 2이고 남는 행은 앞 묶음에 붙습니다.
10. 연습 문제
순위 함수의 동점 처리, 윈도우 절 기본값, LAG의 인수, 윈도우 함수의 규칙을 확인하는 문제입니다. 실제 시험과 같은 유형으로 새로 만들었습니다. 정답과 풀이는 다음 장에 있으니, 먼저 직접 풀어 보세요.
문제 1. [상품] 테이블이 다음과 같을 때, SQL 결과에서 상품번호 P10 행의 R1, R2 값은?
[상품]
| 상품번호 | 판매가 |
|---|---|
| P10 | 3000 |
| P20 | 4000 |
| P30 | 2000 |
| P40 | 5000 |
| P50 | 4000 |
| P60 | 25000 |
SELECT 상품번호,
       RANK()       OVER (ORDER BY 판매가 DESC) AS R1,
       DENSE_RANK() OVER (ORDER BY 판매가 DESC) AS R2
  FROM 상품;
① R1 = 4, R2 = 4
② R1 = 5, R2 = 4
③ R1 = 5, R2 = 5
④ R1 = 4, R2 = 5
문제 2. 문제 1의 [상품] 테이블에서 다음 SQL의 빈칸에 넣었을 때 결과가 3행인 것은?
SELECT 상품번호
  FROM (SELECT 상품번호,
               (        ) OVER (ORDER BY 판매가 DESC) AS 순위
          FROM 상품)
 WHERE 순위 <= 3;
① RANK()
② DENSE_RANK()
③ ROW_NUMBER()
④ 셋 모두 4행이다
문제 3. [주문별금액] 테이블이 다음과 같을 때, SQL 결과에서 주문번호 5005 행의 누적 값은?
[주문별금액]
| 주문번호 | 주문금액 |
|---|---|
| 5001 | 10000 |
| 5002 | 3000 |
| 5003 | 6000 |
| 5004 | 12000 |
| 5005 | 8000 |
| 5006 | 8000 |
| 5007 | 29000 |
SELECT 주문번호, 주문금액,
       SUM(주문금액) OVER (ORDER BY 주문금액) AS 누적
  FROM 주문별금액;
① 8000
② 17000
③ 25000
④ 35000
문제 4. 문제 3의 [주문별금액] 테이블에 주문일시 컬럼이 있고, 주문일시 순서는 주문번호 순서(5001 → 5007)와 같다. 다음 SQL 결과에서 주문번호 5002 행과 5004 행의 V 값을 차례로 고르면?
SELECT 주문번호,
       LAG(주문금액, 2, 0) OVER (ORDER BY 주문일시) AS V
  FROM 주문별금액;
① 0, 3000
② NULL, 3000
③ 10000, 6000
④ 0, 6000
문제 5. 윈도우 함수에 대한 설명으로 가장 적절하지 않은 것은?
① 윈도우 함수는 WHERE 절에 직접 쓸 수 없으므로, 결과로 거르려면 인라인 뷰를 사용한다.
② PARTITION BY를 생략하면 전체 결과가 하나의 파티션이 된다.
③ ROWS는 물리적인 행 수로, RANGE는 정렬 값의 논리적 범위로 윈도우를 지정한다.
④ OVER 절에 ORDER BY만 쓰고 윈도우 절을 생략하면 ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW가 적용된다.
11. 풀이
문제 1. 정답 ②
25000(1), 5000(2), 4000 두 개(3, 3) 다음이 3000입니다. RANK는 동점 2개만큼 건너뛰어 5, DENSE_RANK는 바로 다음 숫자인 4입니다.
문제 2. 정답 ③
RANK와 DENSE_RANK는 4000인 두 상품이 모두 3위라 4행(P60, P40, P20, P50)입니다. ROW_NUMBER는 동점에도 다른 번호를 주므로 3행입니다. 다만 P20과 P50 중 어느 쪽이 3번이 될지는 정렬 기준을 더 주지 않으면 정해지지 않습니다.
문제 3. 정답 ③
윈도우 절을 생략했으므로 RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW입니다. 5005 행의 「현재 행」은 값이 8000인 행 전체(5005, 5006)라서 3000 + 6000 + 8000 + 8000 = 25000입니다. ② 17000은 ROWS로 지정했을 때의 값입니다.
문제 4. 정답 ①
5002는 두 행 앞이 없으므로 세 번째 인수인 기본값 0이 나옵니다. 5004는 두 행 앞인 5002의 3000입니다. 세 번째 인수를 생략했다면 5002는 ②처럼 NULL입니다.
문제 5. 정답 ④
기본값은 ROWS가 아니라 RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW입니다. 동점이 있으면 두 결과가 달라집니다. ①은 WHERE에 쓰면 오류(ORA-30483)가 나므로 맞는 설명입니다.
마치며
이번 글에서는 윈도우 함수를 정리했습니다.
- 윈도우 함수는 행을 줄이지 않고 행마다 순위, 집계, 앞뒤 행 값을 붙이며, SELECT 목록과 ORDER BY 절에만 쓸 수 있습니다.
- RANK는 동점 다음 순위를 건너뛰고(3, 3, 5), DENSE_RANK는 건너뛰지 않으며(3, 3, 4), ROW_NUMBER는 동점에도 다른 번호를 줍니다.
- PARTITION BY는 묶음마다 계산을 새로 시작하고, 그룹별 1등은 인라인 뷰 안에서 순위를 매긴 뒤 바깥에서 거릅니다.
- OVER에 ORDER BY를 쓰면 기본 윈도우가 RANGE 처음부터 현재 행까지라 누적합이 되고, 동점 행은 같은 값(25000, 25000)을 받습니다.
- LAST_VALUE는 기본 범위에서 자기 자신이고, LAG·LEAD의 두 번째 인수는 몇 행, 세 번째 인수는 기본값입니다.
- SQL Server에는 RATIO_TO_REPORT가 없고, RANGE에 값 범위를 쓸 수 없습니다.
다음 글 「계층형 질의와 셀프 조인」에서는 한 테이블 안에서 위아래 관계를 가진 데이터를 다룹니다. 같은 테이블을 두 번 잇는 셀프 조인, START WITH와 CONNECT BY로 트리를 펼치는 계층형 질의, PRIOR의 방향과 LEVEL, WHERE 조건과 CONNECT BY 조건의 차이를 상품분류 예시로 살펴보고 기출 유형 문제로 확인합니다.
참고 자료(공식)
- 데이터자격검정, SQL 개발자(SQLD) 안내: 출제 범위
- Oracle Database SQL Language Reference, Analytic Functions
- Oracle Database SQL Language Reference, RANK
- Oracle Database SQL Language Reference, ROW_NUMBER
- Oracle Database SQL Language Reference, LAG
- Oracle Database SQL Language Reference, NTILE
- Microsoft Learn, SELECT - OVER 절 (Transact-SQL)
- Microsoft Learn, 순위 함수 (Transact-SQL)
'DB' 카테고리의 다른 글
| PIVOT·UNPIVOT과 정규 표현식 (0) | 2026.10.08 |
|---|---|
| 계층형 질의와 셀프 조인 (0) | 2026.10.08 |
| 집합 연산자와 ROLLUP·CUBE·GROUPING SETS (0) | 2026.10.08 |
| 서브쿼리 종류와 NOT IN의 NULL 함정 (0) | 2026.10.08 |
| 표준 조인, INNER·OUTER·CROSS JOIN (0) | 2026.10.08 |


