집합 연산자와 ROLLUP·CUBE·GROUPING SETS
목차
SQLD 2과목의 「집합 연산자」와 「그룹 함수」 항목을 정리합니다. UNION, UNION ALL, INTERSECT, MINUS의 결과와 중복·NULL 처리, 컬럼 수와 타입·결과 컬럼 이름·ORDER BY 위치 같은 집합 연산자 규칙, 오라클과 SQL Server의 연산 우선순위 차이, 소계와 총계를 한 번에 구하는 ROLLUP, CUBE, GROUPING SETS의 결과 행 수, 소계 행을 구분하는 GROUPING 함수를 쇼핑몰 예시로 살펴본 뒤 기출 유형 연습 문제 5개로 확인합니다.
앞 글 「서브쿼리 종류와 NOT IN의 NULL 함정」에서 SQL 안에 SELECT 문을 넣는 방법을 정리했습니다. 이번에는 두 SELECT 문의 결과를 위아래로 합치거나 빼는 집합 연산자와, GROUP BY를 확장해 소계와 총계를 한 번에 만드는 그룹 함수(ROLLUP, CUBE, GROUPING SETS)를 다룹니다. 집합 연산자는 「SELECT 문 기초와 관계형 데이터베이스」에서 본 관계 연산(합집합, 교집합, 차집합)을 실제 SQL로 쓰는 방법이고, 그룹 함수는 「GROUP BY와 HAVING, 집계 함수와 NULL」의 GROUP BY를 이어받습니다. 예시 데이터는 앞 글들과 같은 쇼핑몰 테이블과 가격대, 쿠폰 테이블입니다. 연습 문제는 실제 시험과 같은 유형으로 새로 만든 문제입니다.
1. 집합 연산자 네 가지
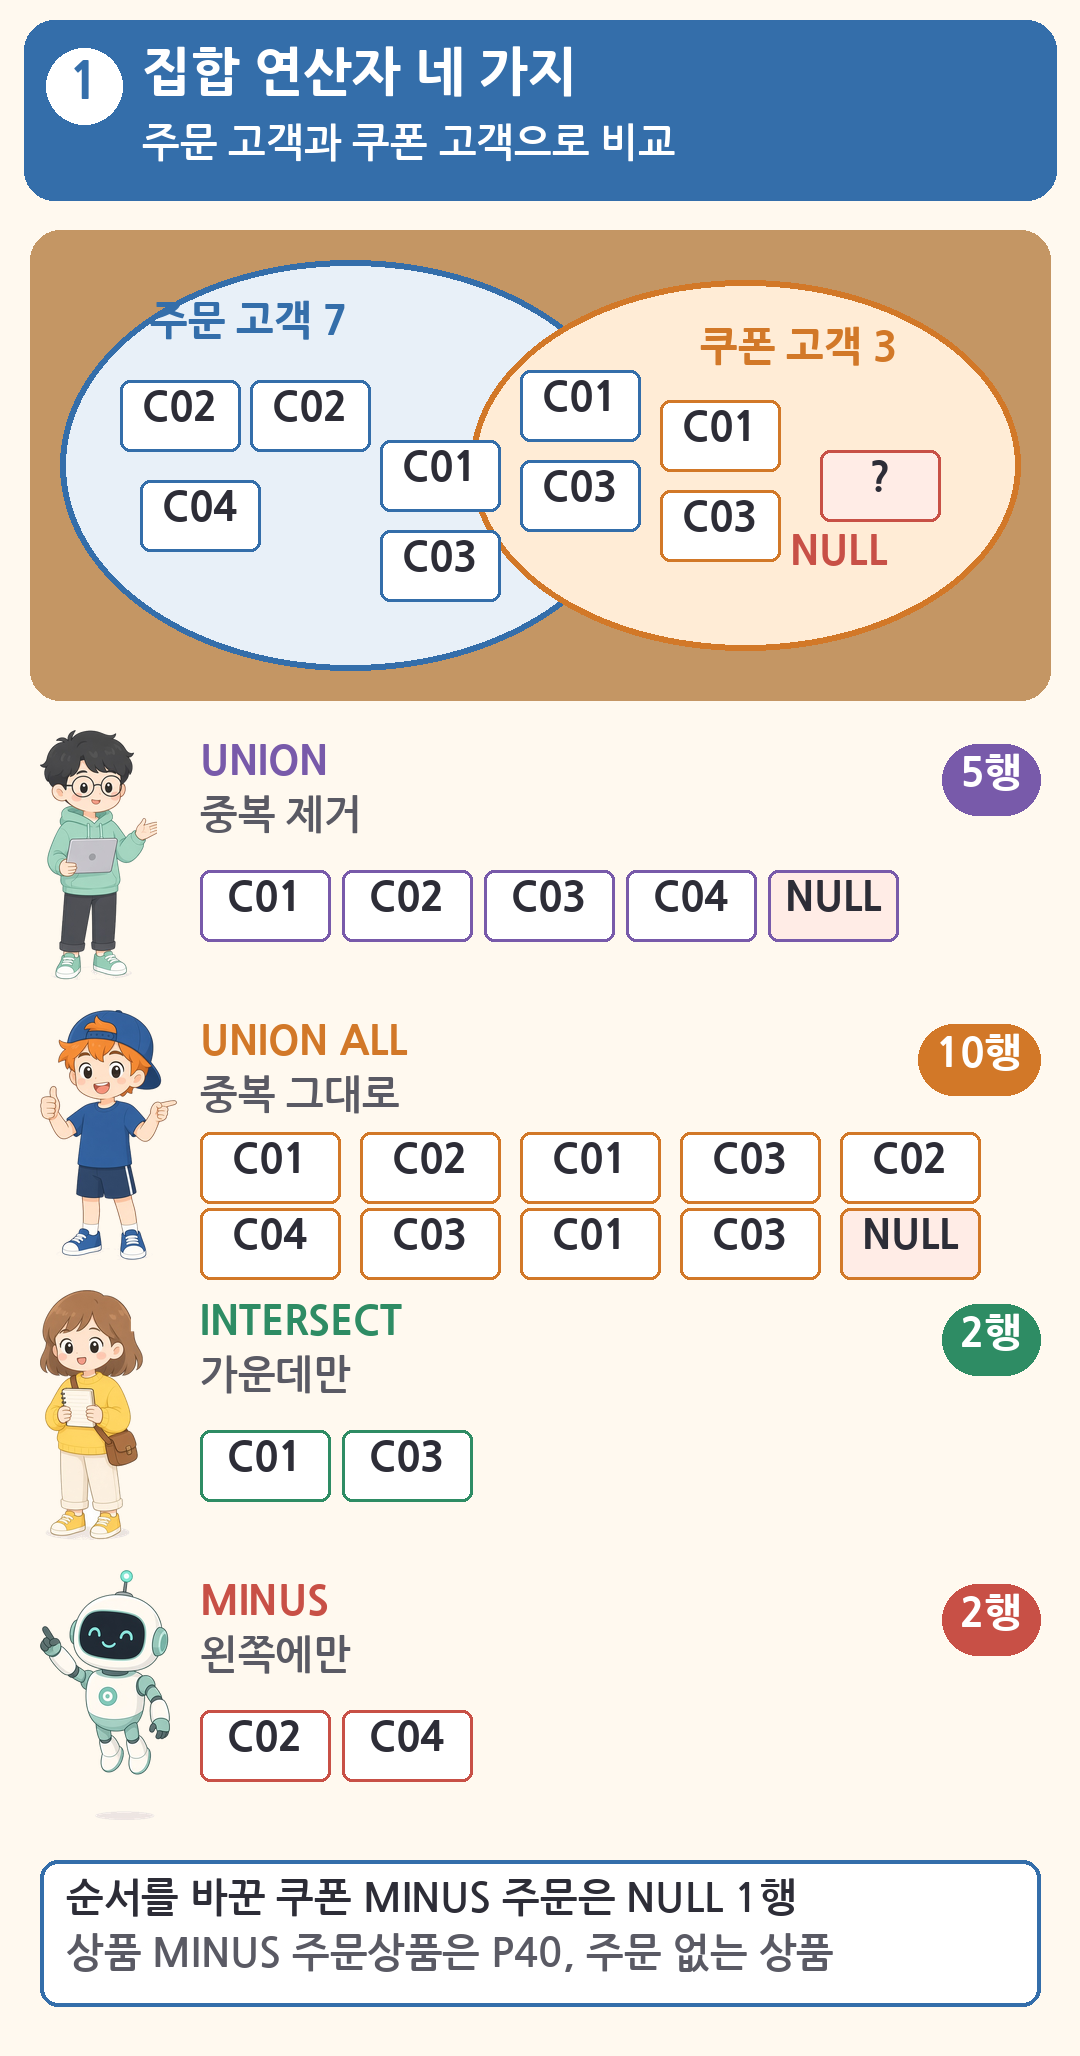
예시로 쓸 두 SELECT 문의 결과는 다음과 같습니다.
- (가)
SELECT 고객번호 FROM 주문: C01, C02, C01, C03, C02, C04, C03 (7행, 중복 있음) - (나)
SELECT 고객번호 FROM 쿠폰: C01, C03, NULL (3행)
| 연산자 | 뜻과 중복 처리 | (가) 연산자 (나)의 결과 |
|---|---|---|
| UNION | 합집합, 중복 제거 | C01, C02, C03, C04, NULL (5행) |
| UNION ALL | 합집합, 중복을 그대로 둠 | 7 + 3 = 10행 |
| INTERSECT | 교집합, 중복 제거 | C01, C03 (2행) |
| MINUS | 차집합(위 결과에서 아래 결과를 뺌), 중복 제거 | C02, C04 (2행) |
SELECT 고객번호 FROM 주문
UNION
SELECT 고객번호 FROM 쿠폰
ORDER BY 고객번호;- UNION ALL만 중복을 남깁니다. 나머지 셋은 결과에서 중복을 없앱니다.
- 차집합은 순서에 따라 결과가 다릅니다. 순서를 바꾼 (나) MINUS (가)의 결과는 NULL 한 행입니다.
SELECT 상품번호 FROM 상품 MINUS SELECT 상품번호 FROM 주문상품의 결과는 P40, 즉 주문이 없는 상품입니다. 앞에서 LEFT JOIN + IS NULL, NOT EXISTS로 구한 질문을 집합 연산자로 푼 것입니다.- 차집합은 시험 기준으로 오라클은 MINUS, SQL Server는 EXCEPT입니다.
2. 집합 연산자 규칙
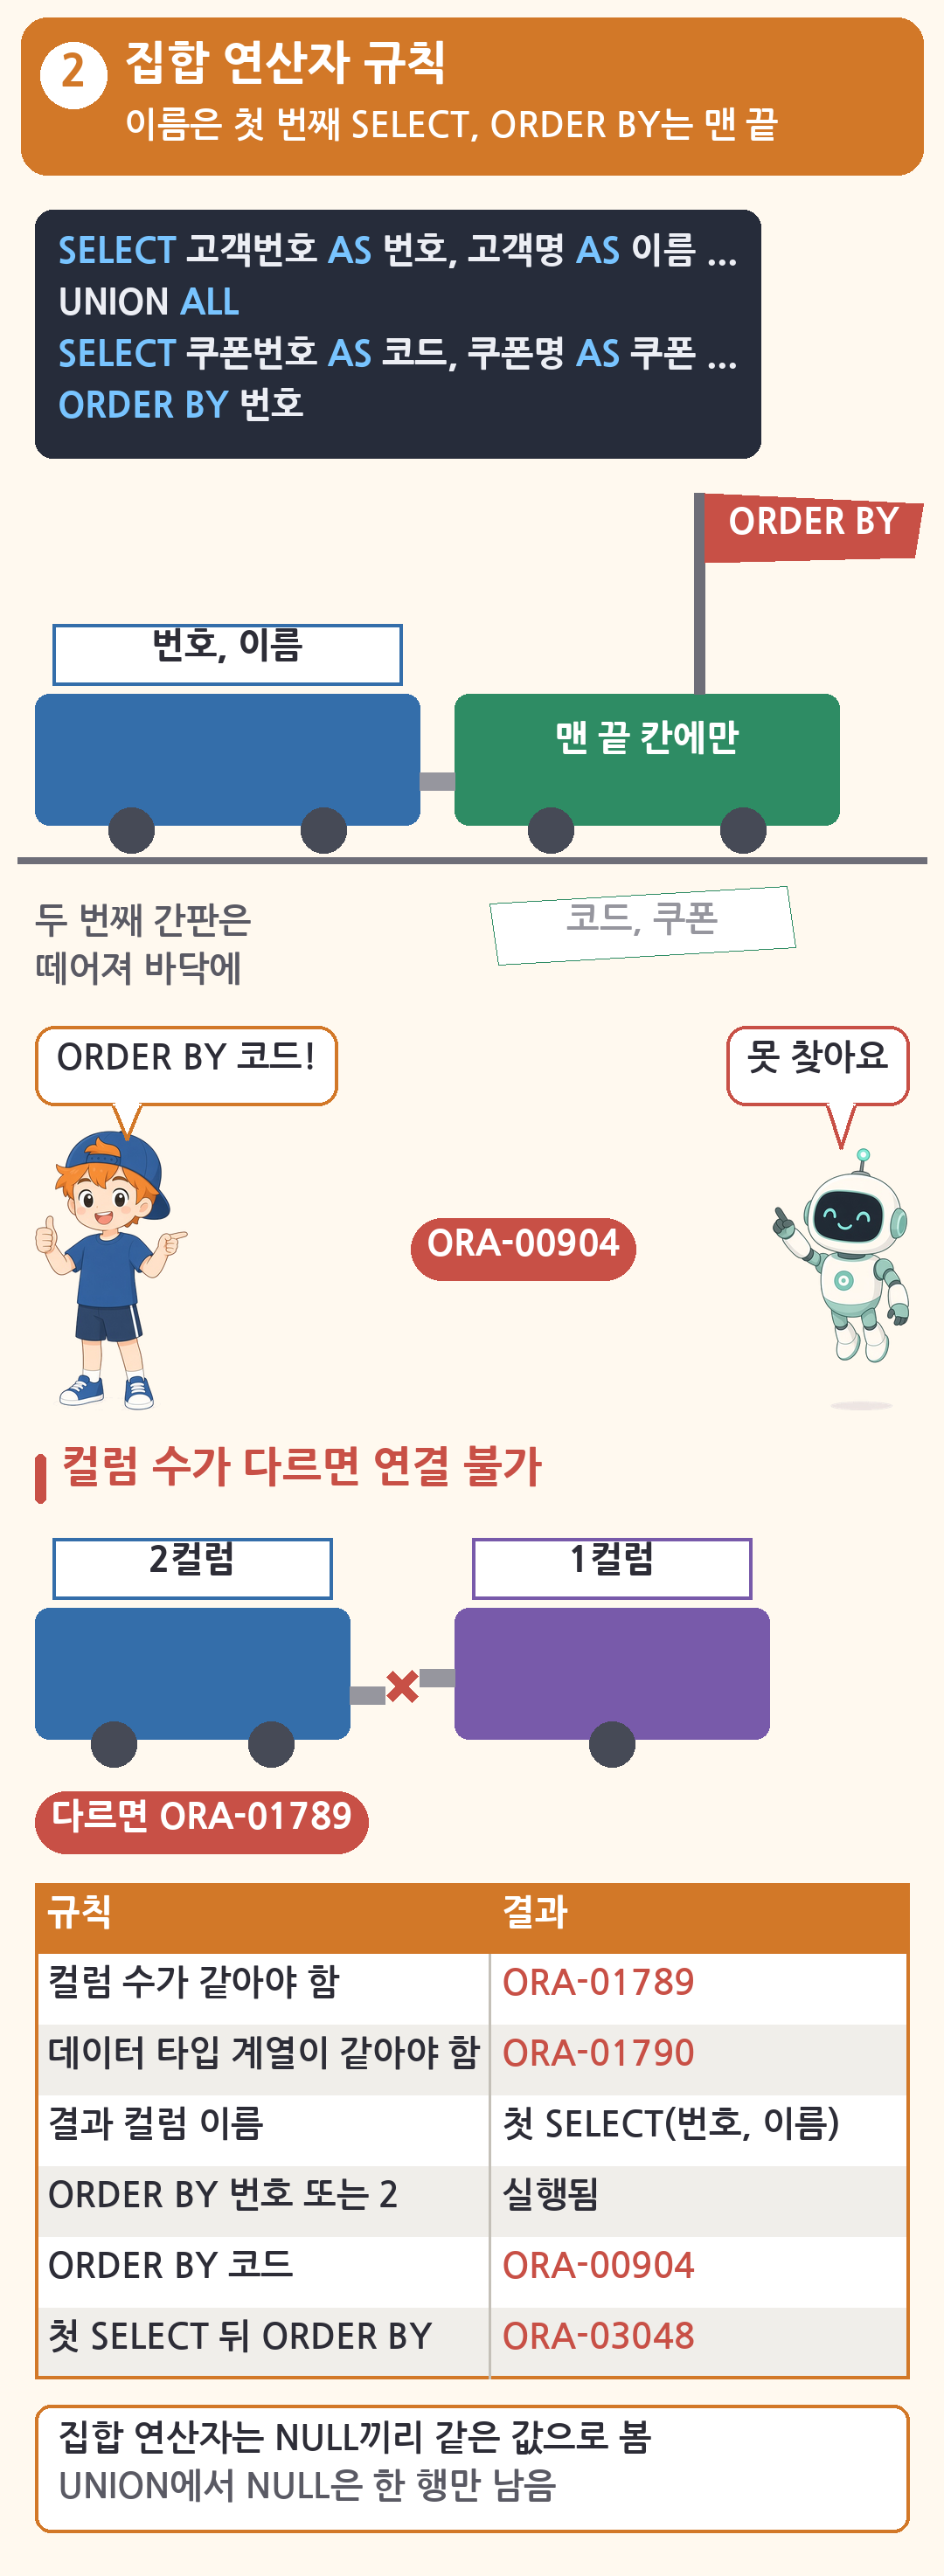
SELECT 고객번호 AS 번호, 고객명 AS 이름 FROM 고객 WHERE 등급코드 = 'G'
UNION ALL
SELECT 쿠폰번호 AS 코드, 쿠폰명 AS 쿠폰 FROM 쿠폰
ORDER BY 번호;| 번호 | 이름 |
|---|---|
| C01 | 김하나 |
| C04 | 최네오 |
| K01 | 여름_10%할인 |
| K02 | 여름10할인 |
| K03 | 가을_5%할인 |
결과 컬럼 이름은 첫 번째 SELECT의 별칭(번호, 이름)을 따릅니다.
| 규칙 | 결과 |
|---|---|
| 위아래 SELECT의 컬럼 수가 같아야 함 | 다르면 오류(ORA-01789) |
| 대응하는 컬럼의 데이터 타입 계열이 같아야 함 | 주문번호(숫자)와 고객번호(문자)를 합치면 오류(ORA-01790) |
| 결과 컬럼 이름은 첫 번째 SELECT 기준 | 위 예에서 번호, 이름 |
| ORDER BY는 맨 마지막에 한 번 | ... ORDER BY 번호 실행됨 |
| ORDER BY에 두 번째 SELECT의 별칭 | ... ORDER BY 코드는 오류(ORA-00904) |
| ORDER BY에 위치 번호 | ... ORDER BY 2 실행됨 |
| 첫 번째 SELECT 뒤에 ORDER BY | 오류(ORA-03048) |
| NULL끼리는 같은 값으로 봄 | UNION에서 NULL은 한 행만 남음 |
- 집합 연산자는 중복을 판단할 때 NULL끼리 같다고 봅니다. 그래서 UNION 결과에 NULL이 한 번만 남습니다.
=나 IN으로 비교할 때 NULL이 어떤 값과도 같지 않은 것과 다릅니다. - 예를 들어 G 등급 고객의 이메일(hana@example.com, NULL)과 S 등급 고객의 이메일(NULL, dasom@example.co.kr)을 INTERSECT하면 NULL 1행이 나오지만, 같은 질문을 IN 서브쿼리로 쓰면 0행입니다.
3. 연산 우선순위
| DBMS | 규칙 |
|---|---|
| 오라클 | 모든 집합 연산자의 우선순위가 같고 왼쪽부터 차례로 계산. 괄호로 순서를 바꿈 |
| SQL Server | INTERSECT가 먼저, 그다음 EXCEPT와 UNION을 왼쪽부터 계산. 괄호가 가장 우선 |
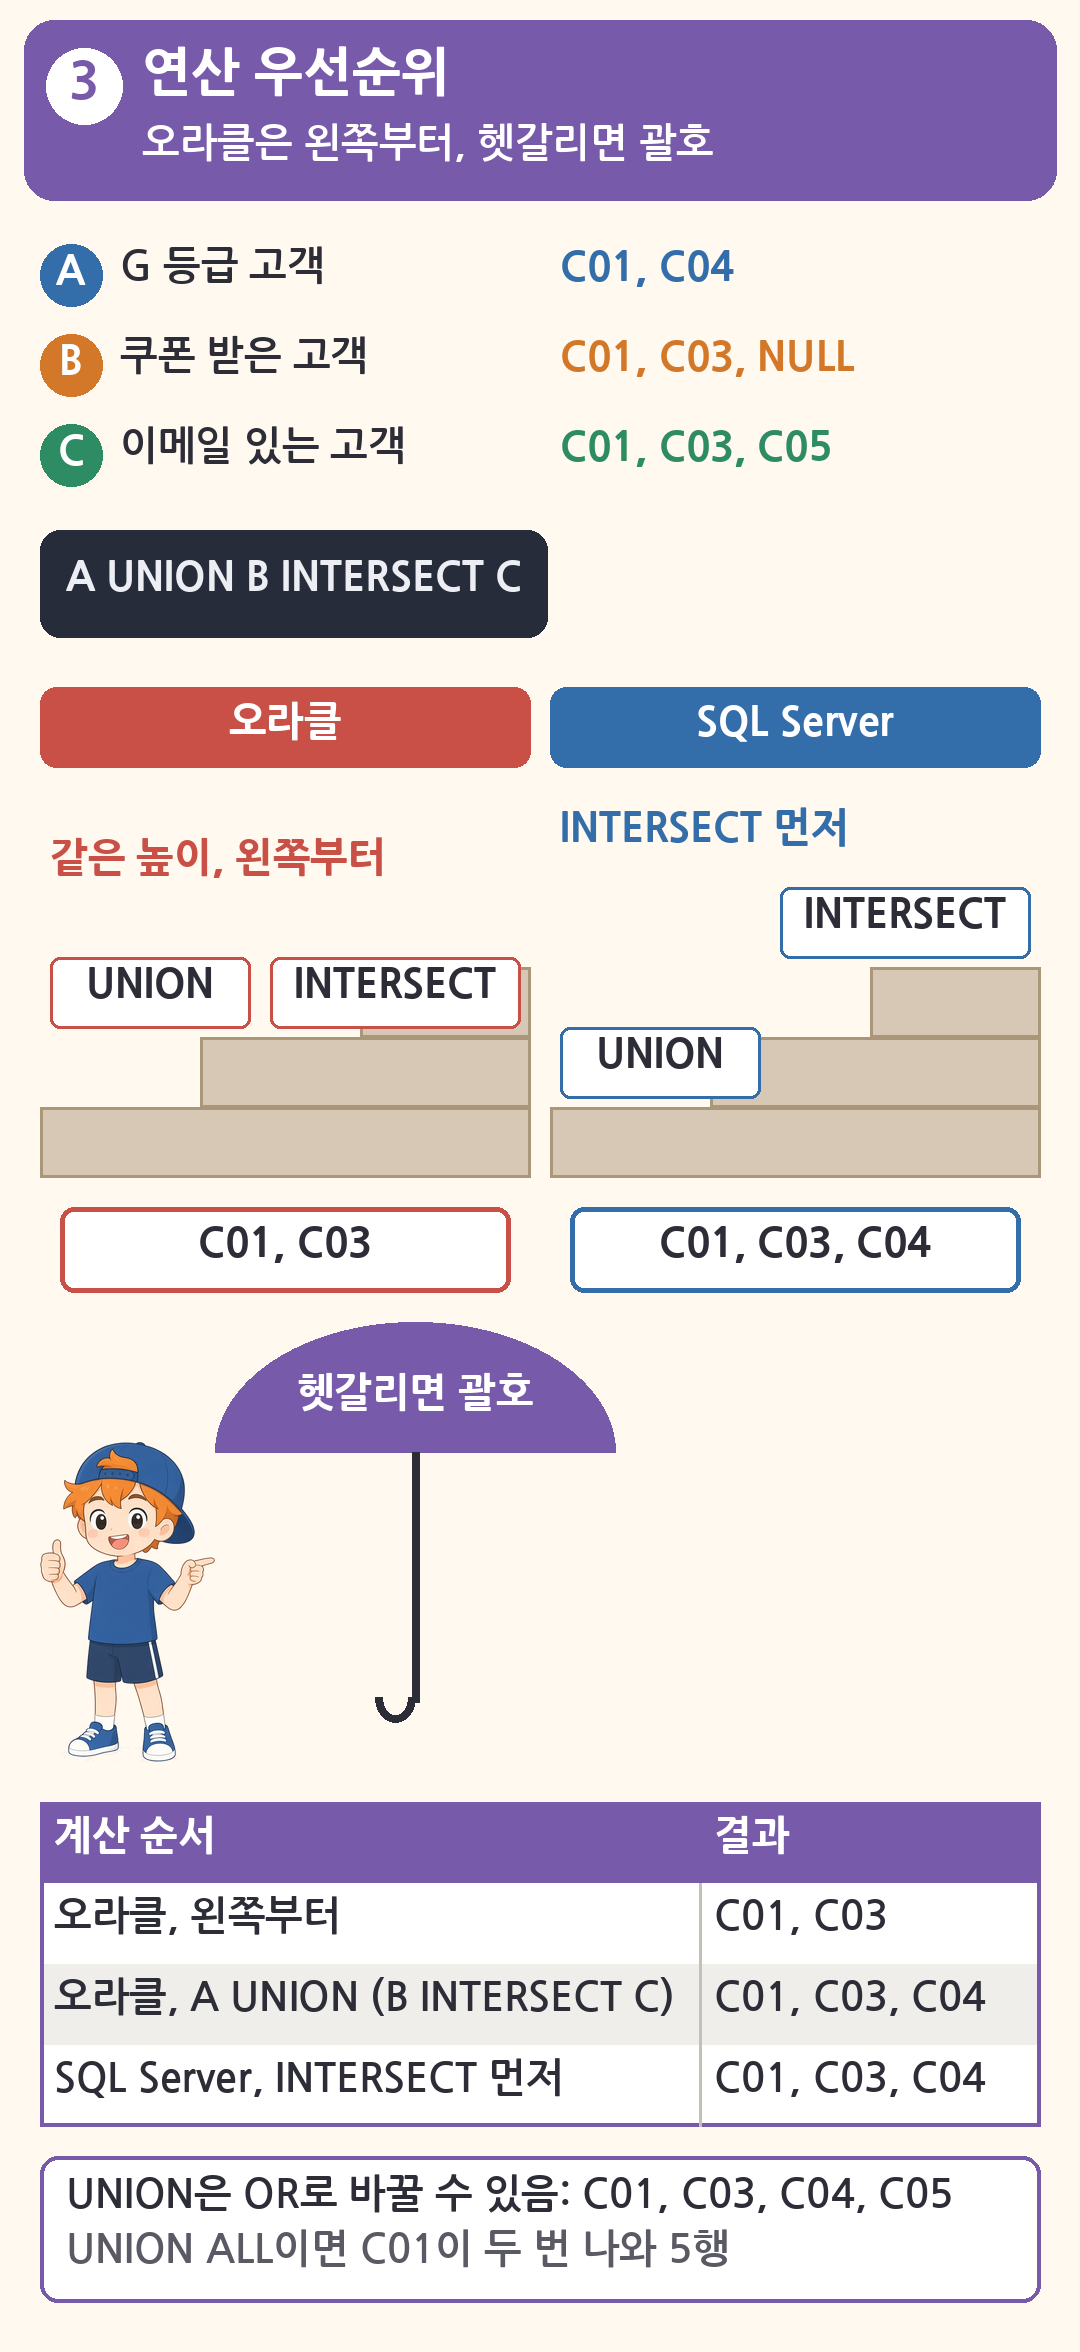
세 집합 A = G 등급 고객 {C01, C04}, B = 쿠폰을 받은 고객 {C01, C03, NULL}, C = 이메일이 있는 고객 {C01, C03, C05}로 확인해 보겠습니다.
SELECT 고객번호 FROM 고객 WHERE 등급코드 = 'G'          -- A
UNION
SELECT 고객번호 FROM 쿠폰                             -- B
INTERSECT
SELECT 고객번호 FROM 고객 WHERE 이메일 IS NOT NULL; -- C| 계산 순서 | 결과 |
|---|---|
| 오라클, 왼쪽부터: (A ∪ B) ∩ C | C01, C03 |
| 오라클에서 괄호로 A UNION (B INTERSECT C) | C01, C03, C04 |
| SQL Server, INTERSECT 먼저: A ∪ (B ∩ C) | C01, C03, C04 |
오라클 문서도 INTERSECT를 다른 집합 연산자와 섞을 때는 괄호를 쓰라고 권장합니다. 헷갈리면 괄호를 칩니다.
UNION과 OR, UNION ALL의 중복
- 같은 테이블에서 조건만 다르면 UNION은 OR로 바꿔 쓸 수 있습니다. G 등급 UNION 이메일 보유 고객은 C01, C03, C04, C05(4행)이고,
WHERE 등급코드 = 'G' OR 이메일 IS NOT NULL과 같습니다. - 이를 UNION ALL로 쓰면 두 조건을 모두 만족하는 C01이 두 번 나와 5행입니다.
- UNION ALL에 상수 컬럼을 붙이면 어느 SELECT에서 온 행인지 구분할 수 있습니다.
SELECT '주문' AS 구분, 고객번호 ... UNION ALL SELECT '쿠폰', 고객번호 ...처럼 씁니다.
4. 그룹 함수와 예시 집계

그룹 함수(ROLLUP, CUBE, GROUPING SETS)는 GROUP BY 절 안에서 써서 소계와 총계를 한 번에 만듭니다. 예시는 「고객 등급 × 상품 가격대별 판매금액」입니다. 주문상품에 주문, 고객, 상품을 등가 조인하고 가격대를 비등가 조인한 뒤 묶습니다.
SELECT c.등급코드, g.가격대코드, SUM(oi.주문수량 * oi.주문단가) AS 판매금액
  FROM 주문상품 oi
  JOIN 주문 o   ON oi.주문번호 = o.주문번호
  JOIN 고객 c   ON o.고객번호 = c.고객번호
  JOIN 상품 p   ON oi.상품번호 = p.상품번호
  JOIN 가격대 g ON p.판매가 BETWEEN g.최저가 AND g.최고가
 GROUP BY c.등급코드, g.가격대코드
ORDER BY c.등급코드, g.가격대코드;| 등급코드 | 가격대코드 | 판매금액 |
|---|---|---|
| B | L | 4000 |
| B | M | 12000 |
| B | V | 25000 |
| G | L | 6000 |
| G | M | 18000 |
| S | L | 2000 |
| S | M | 9000 |
- 합계 76000은 「GROUP BY와 HAVING, 집계 함수와 NULL」에서 구한 주문상품 전체 총금액과 같습니다.
- 고가(H) 구간의 귤은 팔리지 않아 H 행이 없습니다. 판매가 있는 조합 7개만 행이 됩니다.
- 아래 장의 SQL은 모두 이 SQL에서 GROUP BY 줄만 바꾼 것입니다.
5. ROLLUP
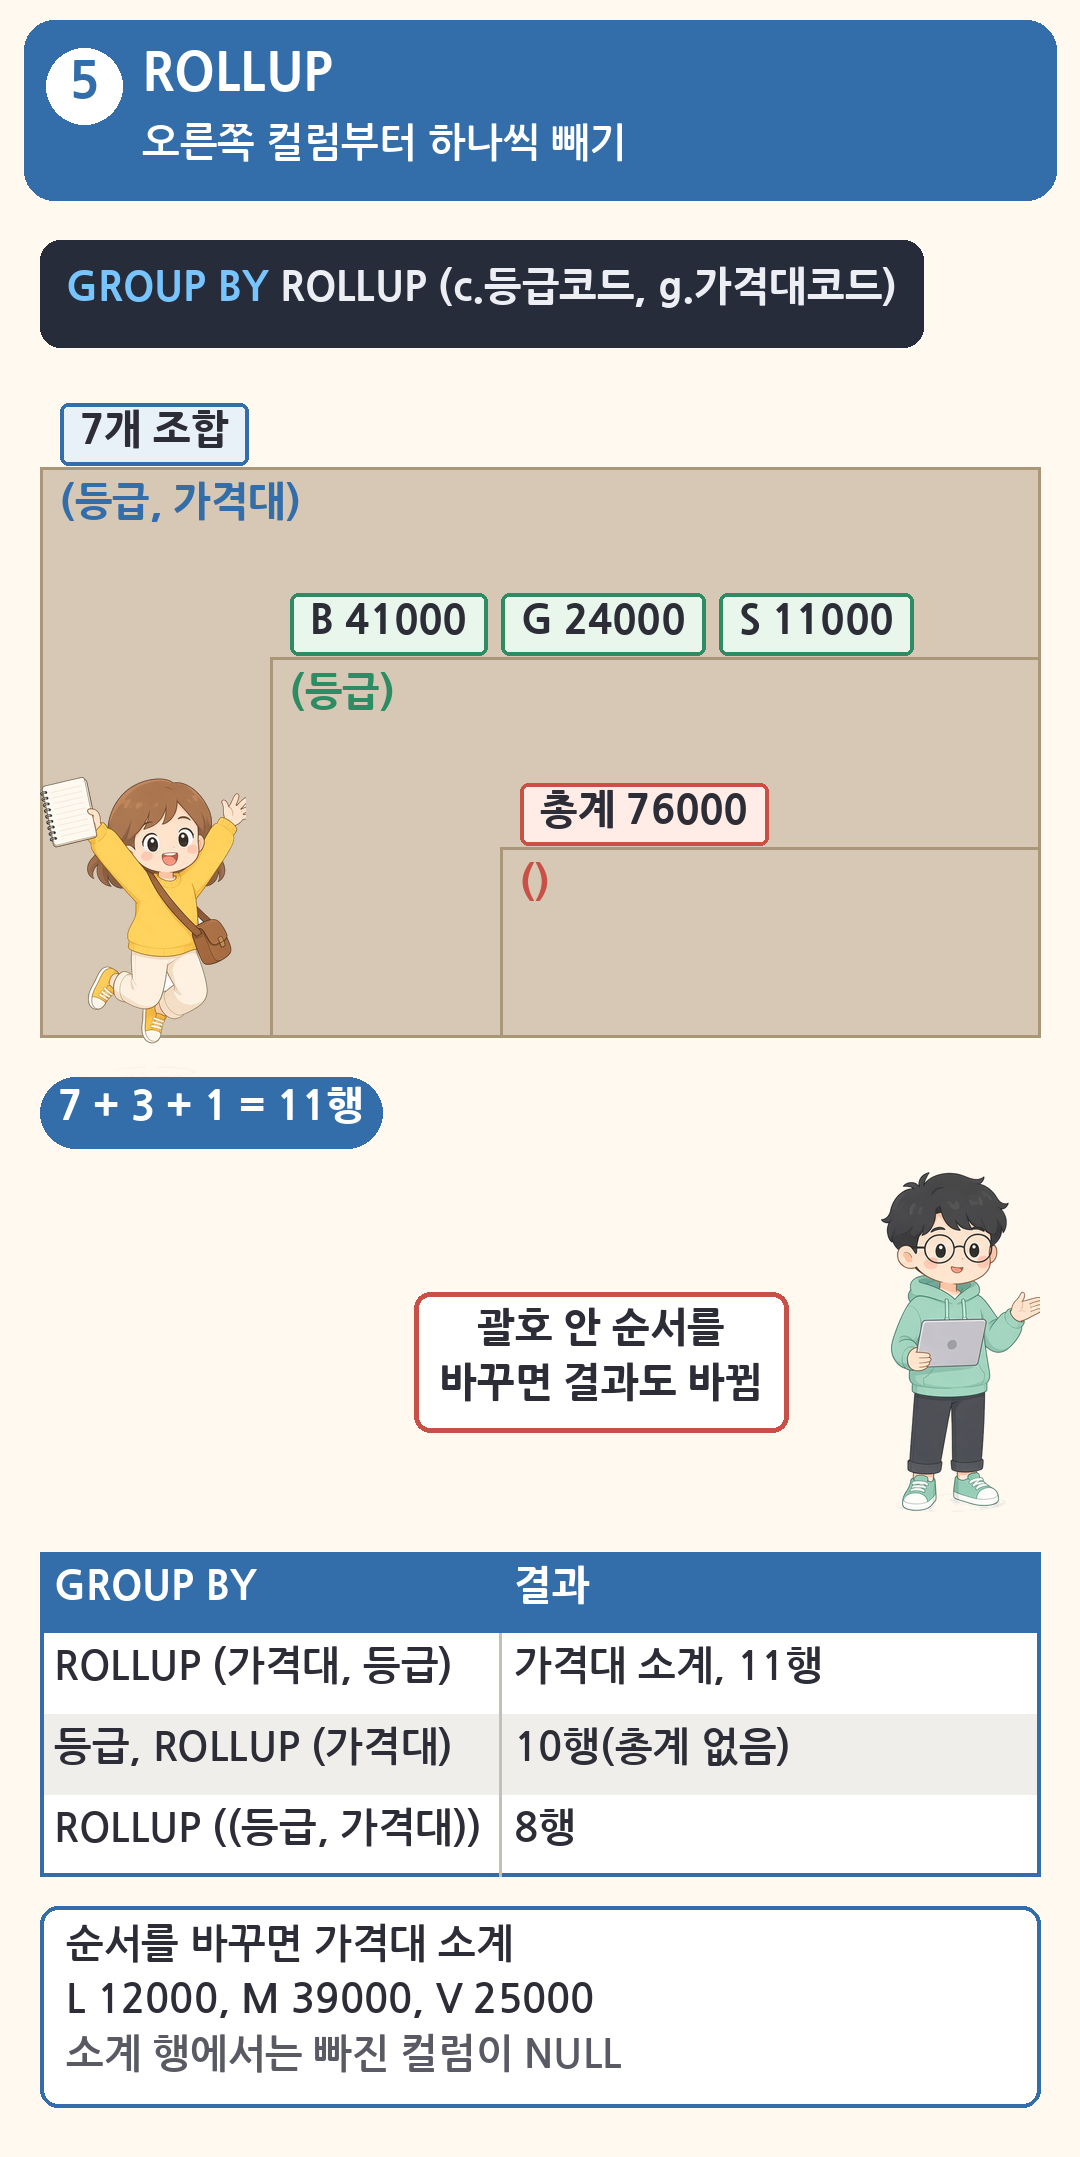
GROUP BY ROLLUP (c.등급코드, g.가격대코드)로 바꾸면 (등급, 가격대) 집계에 등급별 소계와 전체 총계가 더해집니다.
| 등급코드 | 가격대코드 | 판매금액 |
|---|---|---|
| B | L | 4000 |
| B | M | 12000 |
| B | V | 25000 |
| B | NULL | 41000 |
| G | L | 6000 |
| G | M | 18000 |
| G | NULL | 24000 |
| S | L | 2000 |
| S | M | 9000 |
| S | NULL | 11000 |
| NULL | NULL | 76000 |
- ROLLUP(A, B)는 (A, B) → (A) → () 순서로 오른쪽 컬럼부터 하나씩 빼며 그룹을 만듭니다. 그룹 개수는 n + 1 = 3이고, 결과는 7 + 등급 소계 3 + 총계 1 = 11행입니다.
- 소계 행에서는 빠진 컬럼(가격대코드)이 NULL로 나옵니다.
- 등급 소계는 「조인 기초, 등가 조인과 오라클 (+) 표기」의 고객별 구매금액과 맞습니다. B 41000은 박세미, G 24000은 김하나 16000 + 최네오 8000, S 11000은 이두리입니다.
- ROLLUP은 괄호 안 순서가 바뀌면 결과가 바뀝니다.
ROLLUP (g.가격대코드, c.등급코드)는 등급 소계 대신 가격대 소계(L 12000, M 39000, V 25000)를 만듭니다. 행 수는 똑같이 11행입니다.
| GROUP BY | 만드는 그룹 | 결과 행 수 |
|---|---|---|
등급, ROLLUP (가격대) |
(등급, 가격대), (등급) | 10행(총계 없음) |
ROLLUP ((등급, 가격대)) |
(등급, 가격대), () | 8행(괄호로 묶은 컬럼은 한 덩어리) |
ROLLUP (고객번호) |
(고객번호), () | 주문 테이블에서 5행 |
마지막 줄처럼 컬럼 하나짜리 ROLLUP은 「GROUP BY 결과 + 총계 한 줄」입니다. 주문 건수로 보면 C01 2, C02 2, C03 2, C04 1, 총계 7이고, GROUP BY 고객번호 결과에 SELECT NULL, COUNT(*) FROM 주문을 UNION ALL한 것과 같습니다.
6. CUBE와 GROUPING SETS
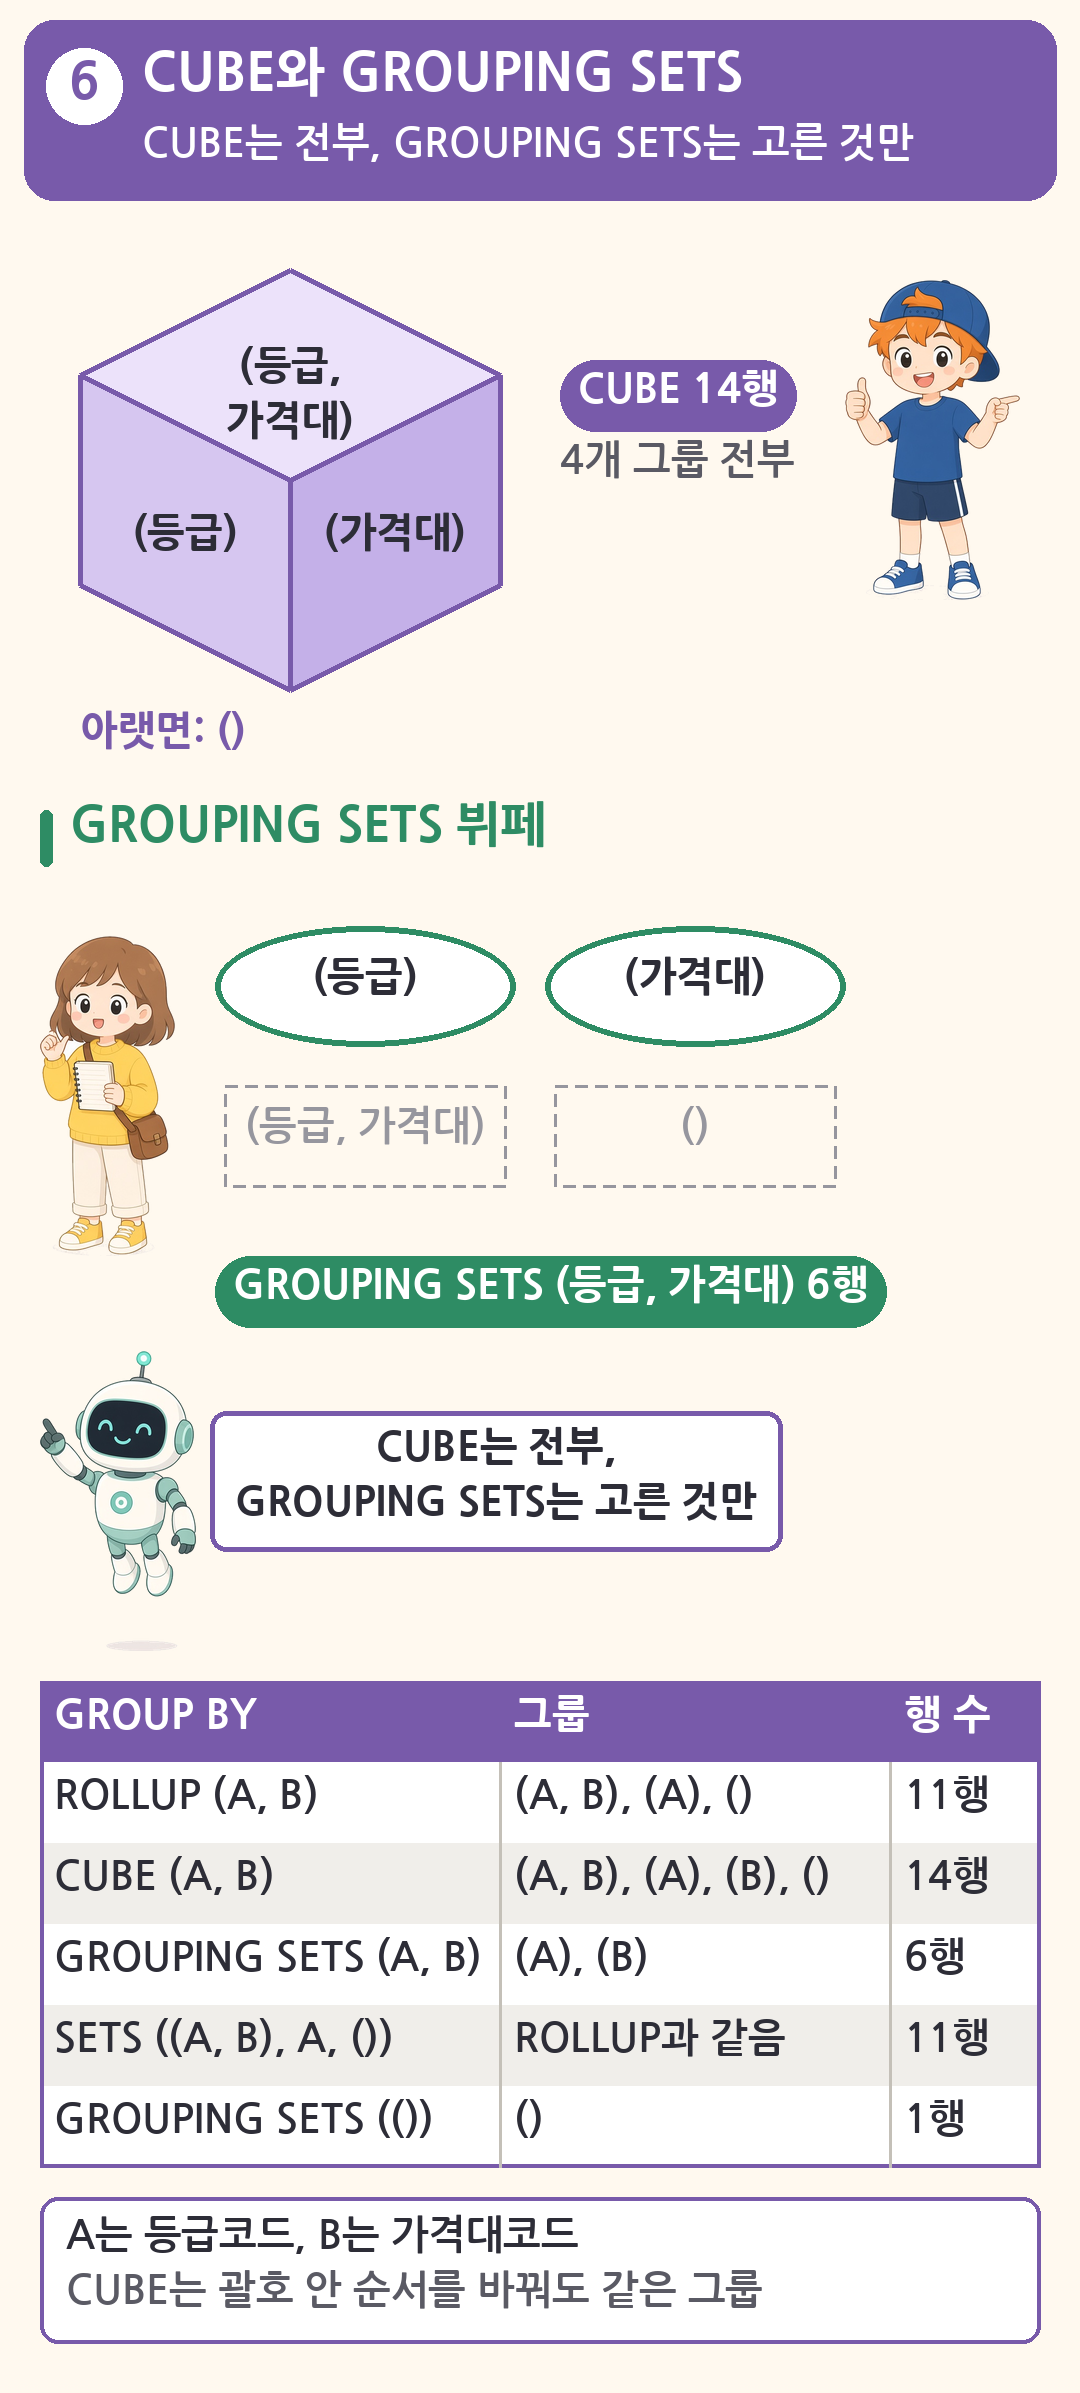
| GROUP BY | 만드는 그룹과 결과 행 수 |
|---|---|
ROLLUP (A, B) |
(A, B), (A), () → 11행 |
CUBE (A, B) |
(A, B), (A), (B), () → 14행 |
GROUPING SETS (A, B) |
(A), (B) → 6행 |
GROUPING SETS ((A, B), A, ()) |
(A, B), (A), () → 11행 |
GROUPING SETS (()) |
() → 1행 |
A는 등급코드, B는 가격대코드입니다.
- CUBE는 가능한 모든 조합(2ⁿ = 4개 그룹)을 만듭니다. ROLLUP의 11행에 가격대 소계 3행(L 12000, M 39000, V 25000)이 더해져 14행입니다. 괄호 안 순서를 바꿔도 같은 그룹이 만들어지고, 보이는 순서만 달라집니다.
- GROUPING SETS는 지정한 그룹만 만듭니다.
GROUPING SETS (A, B)는 (A, B) 조합 집계가 아니라 등급별 소계 3행과 가격대별 소계 3행을 따로 만든 것입니다. 조합 집계까지 원하면(A, B)를 괄호로 묶어 넣습니다. - GROUPING SETS는 지정한 그룹별 집계를 UNION ALL한 것과 같습니다. 그래서
GROUPING SETS ((A, B), A, ())는 ROLLUP(A, B)와 결과가 같습니다. 반면GROUPING SETS ((A, B), B, ())는 가격대 소계를 만들어 ROLLUP(B, A)와 같은 그룹이 됩니다. - 그룹 개수(ROLLUP n + 1, CUBE 2ⁿ)와 결과 행 수는 다릅니다. 행 수는 데이터에 따라 달라집니다.
7. GROUPING 함수
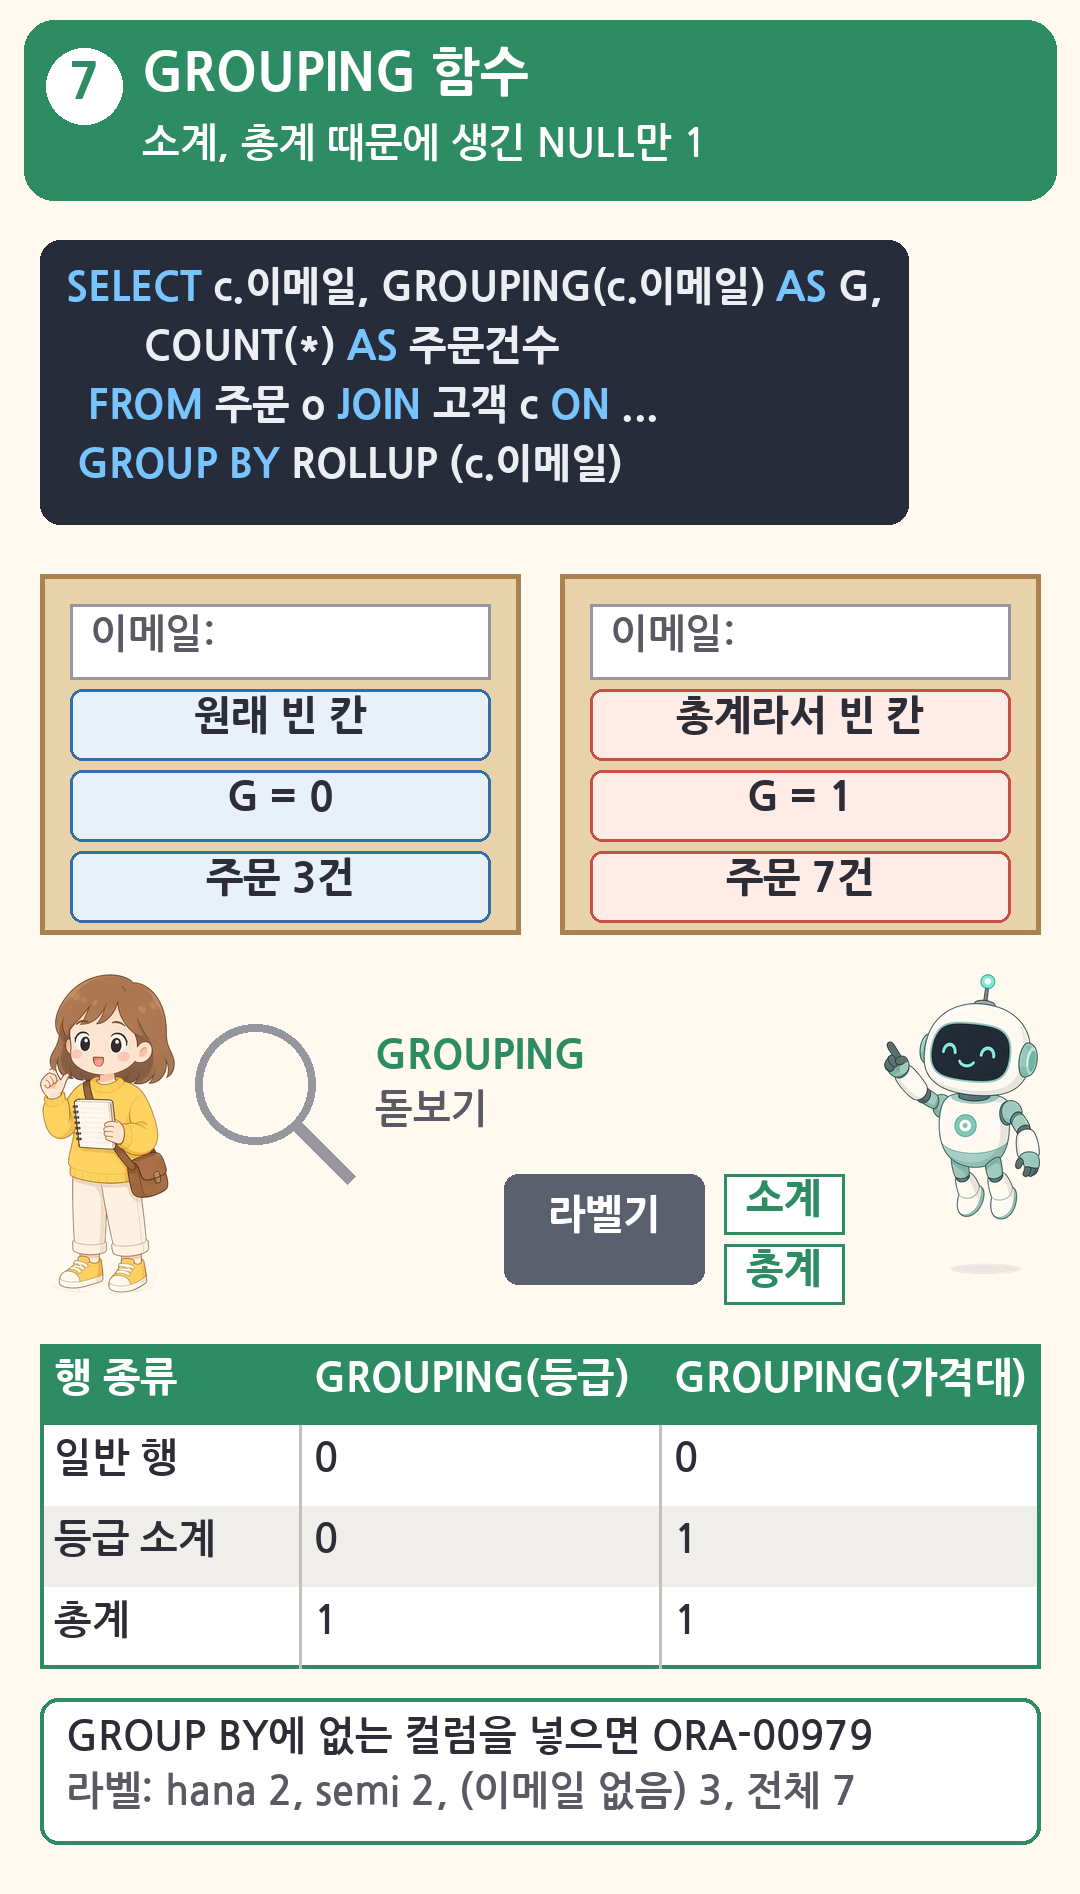
소계 행의 NULL에 「소계」, 「총계」 같은 이름을 붙이려면 GROUPING 함수를 씁니다. GROUPING(컬럼)은 그 컬럼이 소계나 총계 때문에 NULL이 된 행이면 1, 아니면 0을 돌려줍니다.
SELECT CASE GROUPING(c.등급코드) WHEN 1 THEN '전체' ELSE c.등급코드 END AS 등급,
       CASE WHEN GROUPING(c.등급코드) = 1 THEN '총계'
            WHEN GROUPING(g.가격대코드) = 1 THEN '소계'
            ELSE g.가격대코드 END AS 가격대,
       SUM(oi.주문수량 * oi.주문단가) AS 판매금액
  FROM 주문상품 oi
  JOIN 주문 o   ON oi.주문번호 = o.주문번호
  JOIN 고객 c   ON o.고객번호 = c.고객번호
  JOIN 상품 p   ON oi.상품번호 = p.상품번호
  JOIN 가격대 g ON p.판매가 BETWEEN g.최저가 AND g.최고가
 GROUP BY ROLLUP (c.등급코드, g.가격대코드)
ORDER BY c.등급코드, g.가격대코드;| 등급 | 가격대 | 판매금액 |
|---|---|---|
| B | L | 4000 |
| B | M | 12000 |
| B | V | 25000 |
| B | 소계 | 41000 |
| G | L | 6000 |
| G | M | 18000 |
| G | 소계 | 24000 |
| S | L | 2000 |
| S | M | 9000 |
| S | 소계 | 11000 |
| 전체 | 총계 | 76000 |
| 행 종류 | GROUPING(등급코드) | GROUPING(가격대코드) |
|---|---|---|
| 일반 행 | 0 | 0 |
| 등급 소계 | 0 | 1 |
| 총계 | 1 | 1 |
원래 NULL과 소계 NULL 구분하기
고객 이메일별 주문 건수를 ROLLUP하면 NULL이 두 번 나옵니다.
SELECT c.이메일, GROUPING(c.이메일) AS G, COUNT(*) AS 주문건수
  FROM 주문 o JOIN 고객 c ON o.고객번호 = c.고객번호
GROUP BY ROLLUP (c.이메일);| 이메일 | G | 주문건수 |
|---|---|---|
| hana@example.com | 0 | 2 |
| semi@example.com | 0 | 2 |
| NULL | 0 | 3 |
| NULL | 1 | 7 |
- 이메일이 NULL인 이두리(5002, 5005)와 최네오(5006)의 주문 3건은 원래 데이터가 NULL인 그룹이라 G = 0입니다. 맨 아래 7건은 총계 때문에 생긴 NULL이라 G = 1입니다. 이메일 값만 보면 둘 다 NULL이라 구분할 수 없고, GROUPING으로만 구분됩니다.
CASE WHEN GROUPING(c.이메일) = 1 THEN '전체' ELSE NVL(c.이메일, '(이메일 없음)') END로 이름을 붙이면 hana 2, semi 2, (이메일 없음) 3, 전체 7이 됩니다.- GROUPING의 인수는 GROUP BY에 있는 식이어야 합니다.
GROUPING(주문일시)처럼 GROUP BY에 없는 컬럼을 쓰면 오류(ORA-00979)입니다. - 여러 컬럼의 GROUPING 값을 이진수처럼 이어 붙인 정수를 돌려주는 GROUPING_ID 함수도 있습니다.
8. SQL Server와의 차이
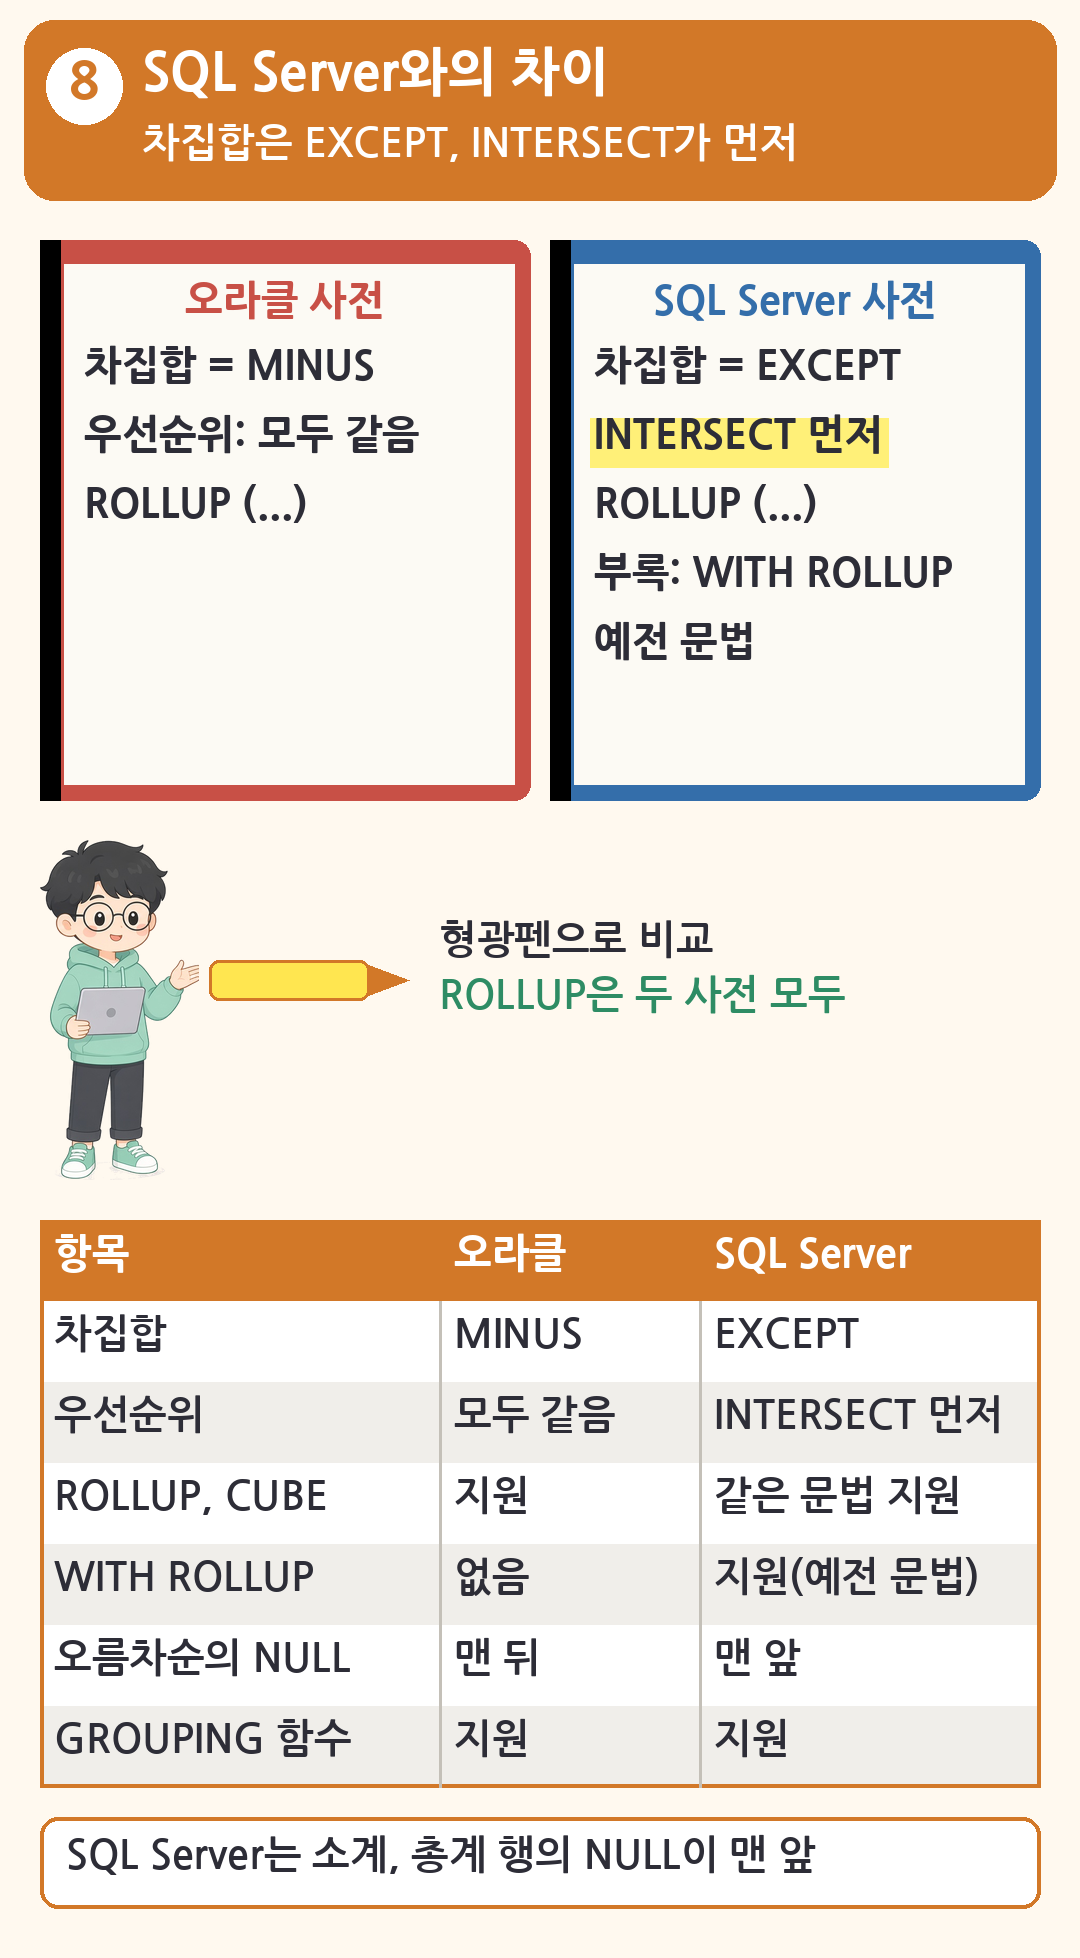
| 항목 | 오라클 | SQL Server |
|---|---|---|
| 차집합 | MINUS(시험 기준) | EXCEPT |
| 집합 연산자 우선순위 | 모두 같음, 왼쪽부터 | INTERSECT 먼저 |
| ROLLUP, CUBE, GROUPING SETS | GROUP BY ROLLUP (...) |
같은 문법 지원 |
GROUP BY ... WITH ROLLUP |
없음 | 지원(예전 문법) |
| 오름차순 정렬에서 NULL | 맨 뒤 | 맨 앞 |
| GROUPING 함수 | 지원 | 지원 |
- SQL Server의
WITH ROLLUP,WITH CUBE는 이전 호환용으로 남아 있는 예전 문법이고, 표준 문법ROLLUP (...)을 권장합니다. - ROLLUP과 CUBE 결과는 ORDER BY가 없으면 정렬이 보장되지 않습니다. 이 글의 결과 표는 모두 ORDER BY를 붙인 결과입니다. SQL Server에서 같은 ORDER BY를 쓰면 소계·총계 행의 NULL이 맨 앞에 옵니다.
9. 헷갈리기 쉬운 점
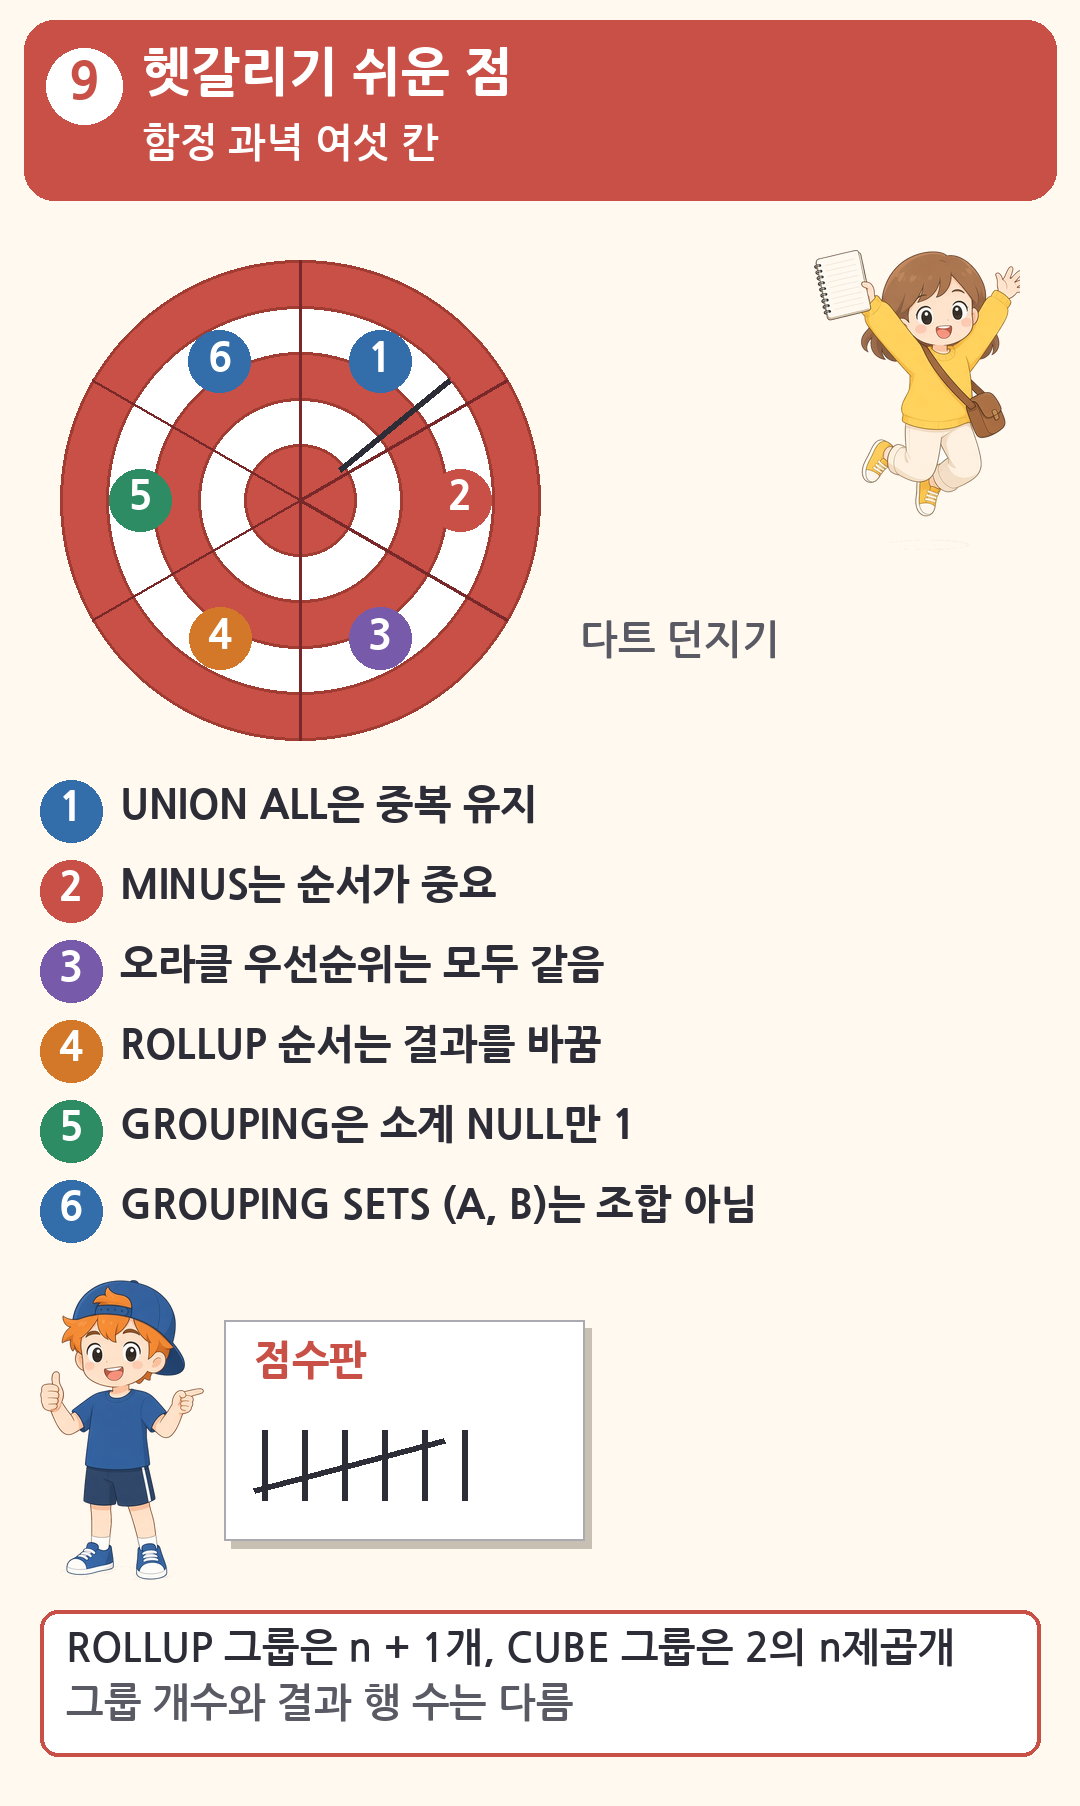
- UNION은 중복 제거, UNION ALL은 그대로입니다. UNION ALL의 행 수는 위아래 행 수의 합입니다. UNION 결과가 정렬되어 보여도 보장되지 않으므로 ORDER BY를 붙입니다.
- 결과 컬럼 이름은 첫 번째 SELECT 기준입니다. ORDER BY에도 첫 번째 SELECT의 이름·별칭이나 위치 번호를 씁니다.
- ORDER BY는 맨 마지막에 한 번만 씁니다. 중간 SELECT에 쓰면 오류입니다.
- MINUS는 순서가 중요합니다. A MINUS B와 B MINUS A는 다릅니다.
- 집합 연산자는 NULL을 같은 값으로 봅니다. UNION에서 NULL은 한 번만 남고, INTERSECT에서는 NULL끼리 짝이 됩니다.
=, IN 비교와 다릅니다. - 오라클 집합 연산자의 우선순위는 모두 같습니다. SQL Server처럼 INTERSECT를 먼저 계산하면 결과를 틀립니다. 헷갈리면 괄호를 씁니다.
- ROLLUP 그룹은 n + 1개, CUBE 그룹은 2ⁿ개입니다. 그룹 개수와 결과 행 수를 구분합니다.
- ROLLUP은 순서가 결과를 바꾸고, CUBE는 바꾸지 않습니다.
- GROUPING은 「소계·총계 때문에 생긴 NULL」에만 1입니다. 원래 데이터가 NULL인 그룹은 0입니다.
- GROUPING SETS (A, B)는 (A, B) 조합 집계가 아닙니다. A별, B별 집계를 따로 만들어 합친 것입니다.
10. 연습 문제

집합 연산자의 결과와 규칙, ROLLUP·CUBE·GROUPING SETS, GROUPING 함수를 확인하는 문제입니다. 실제 시험과 같은 유형으로 새로 만들었습니다. 정답과 풀이는 다음 장에 있으니, 먼저 직접 풀어 보세요.
문제 1. [주문]의 고객번호 컬럼 값은 C01, C02, C01, C03, C02, C04, C03이고, [쿠폰]의 고객번호 컬럼 값은 C01, C03, NULL이다. 다음 SQL의 결과 행 수는?
SELECT 고객번호 FROM 주문
UNION
SELECT 고객번호 FROM 쿠폰;
① 4
② 5
③ 9
④ 10
문제 2. 고객번호와 쿠폰번호는 모두 문자 컬럼이다. 오라클 기준으로 오류가 발생하는 SQL은?
① SELECT 고객번호 AS 번호 FROM 고객 UNION SELECT 쿠폰번호 AS 코드 FROM 쿠폰 ORDER BY 번호;
② SELECT 고객번호 AS 번호 FROM 고객 UNION SELECT 쿠폰번호 AS 코드 FROM 쿠폰 ORDER BY 1;
③ SELECT 고객번호 AS 번호 FROM 고객 UNION ALL SELECT 쿠폰번호 AS 코드 FROM 쿠폰;
④ SELECT 고객번호 AS 번호 FROM 고객 UNION SELECT 쿠폰번호 AS 코드 FROM 쿠폰 ORDER BY 코드;
문제 3. 등급코드(B, G, S)와 가격대코드별 판매금액이 다음 7개 조합에만 있다. GROUP BY ROLLUP (등급코드, 가격대코드)의 결과 행 수는?
| 등급코드 | 가격대코드 | 판매금액 |
|---|---|---|
| B | L | 4000 |
| B | M | 12000 |
| B | V | 25000 |
| G | L | 6000 |
| G | M | 18000 |
| S | L | 2000 |
| S | M | 9000 |
① 8
② 10
③ 11
④ 14
문제 4. GROUP BY ROLLUP (등급코드, 가격대코드)와 같은 결과를 내는 것은?
① GROUP BY GROUPING SETS ((등급코드, 가격대코드), 등급코드, ())
② GROUP BY GROUPING SETS (등급코드, 가격대코드)
③ GROUP BY GROUPING SETS ((등급코드, 가격대코드), 가격대코드, ())
④ GROUP BY CUBE (등급코드, 가격대코드)
문제 5. 고객 이메일별 주문 건수를 다음 SQL로 구했다. 이메일이 NULL인 고객의 주문이 3건, 전체 주문이 7건일 때 (가), (나)에 들어갈 값으로 옳은 것은?
SELECT c.이메일, GROUPING(c.이메일) AS G, COUNT(*) AS 주문건수
  FROM 주문 o JOIN 고객 c ON o.고객번호 = c.고객번호
GROUP BY ROLLUP (c.이메일);| 이메일 | G | 주문건수 |
|---|---|---|
| hana@example.com | 0 | 2 |
| semi@example.com | 0 | 2 |
| NULL | (가) | 3 |
| NULL | (나) | 7 |
① (가) 0, (나) 0
② (가) 0, (나) 1
③ (가) 1, (나) 0
④ (가) 1, (나) 1
11. 풀이
문제 1. 정답 ②
UNION은 두 결과를 합친 뒤 중복을 없앱니다. C01, C02, C03, C04에 쿠폰 쪽 NULL이 더해져 5행입니다. NULL도 하나의 값으로 한 번 남습니다. UNION ALL이었다면 ④의 10행입니다.
문제 2. 정답 ④
결과 컬럼 이름은 첫 번째 SELECT의 별칭(번호)을 따르므로, 두 번째 SELECT의 별칭(코드)으로는 정렬할 수 없습니다(ORA-00904). 첫 번째 별칭(①)이나 위치 번호(②)로는 정렬되고, ③은 ORDER BY가 없는 UNION ALL이라 실행됩니다.
문제 3. 정답 ③
ROLLUP은 (등급, 가격대) 7행 + 등급별 소계 3행(B, G, S) + 총계 1행 = 11행입니다. ④ 14는 가격대 소계 3행이 더해지는 CUBE, ② 10은 총계가 없는 GROUP BY 등급코드, ROLLUP (가격대코드), ① 8은 두 컬럼을 한 덩어리로 묶은 ROLLUP ((등급코드, 가격대코드))의 결과입니다.
문제 4. 정답 ①
ROLLUP(A, B)는 (A, B), (A), () 세 그룹이므로 GROUPING SETS ((A, B), A, ())와 같습니다. ③은 가격대 소계를 만들어 ROLLUP(가격대코드, 등급코드)와 같은 그룹이 되고, ②는 소계만 6행, ④는 14행입니다.
문제 5. 정답 ②
이메일이 원래 NULL인 고객 그룹(3건)은 데이터에 있는 NULL이라 GROUPING 값이 0이고, ROLLUP이 만든 총계 행(7건)의 NULL만 1입니다.
마치며
이번 글에서는 집합 연산자와 그룹 함수를 정리했습니다.
- UNION은 중복 제거, UNION ALL은 중복 유지, INTERSECT는 교집합, MINUS는 차집합입니다. 예시에서 UNION 5행, UNION ALL 10행, INTERSECT 2행, MINUS 2행입니다.
- 위아래 SELECT의 컬럼 수와 타입 계열이 같아야 하고, 결과 컬럼 이름은 첫 번째 SELECT를 따르며, ORDER BY는 맨 마지막에 한 번 씁니다.
- 집합 연산자는 NULL을 같은 값으로 보고, 오라클은 모든 집합 연산자를 왼쪽부터 계산합니다. SQL Server는 INTERSECT가 먼저입니다.
- ROLLUP(A, B)는 (A, B), (A), () 세 그룹, CUBE(A, B)는 네 그룹을 만듭니다. 예시에서 ROLLUP 11행, CUBE 14행, GROUPING SETS (A, B) 6행입니다.
- GROUPING 함수는 소계·총계 때문에 생긴 NULL에만 1을 돌려주므로, 원래 NULL과 소계 NULL을 구분할 수 있습니다.
다음 글 「윈도우 함수, 순위·집계·LAG/LEAD」에서는 행을 묶지 않고 행마다 순위와 누적 합계, 앞뒤 행의 값을 계산하는 윈도우 함수를 다룹니다. RANK, DENSE_RANK, ROW_NUMBER의 차이와 PARTITION BY, 집계 윈도우 함수, LAG와 LEAD를 쇼핑몰 예시로 살펴보고 기출 유형 문제로 확인합니다.
참고 자료(공식)
- 데이터자격검정, SQL 개발자(SQLD) 안내: 출제 범위
- Oracle Database SQL Language Reference, The UNION ALL, INTERSECT, MINUS Operators
- Oracle Database SQL Language Reference, SELECT(group_by_clause)
- Oracle Database SQL Language Reference, GROUPING
- Oracle Database Data Warehousing Guide, SQL for Aggregation in Data Warehouses
- Microsoft Learn, Set Operators - EXCEPT and INTERSECT (Transact-SQL)
- Microsoft Learn, GROUP BY (Transact-SQL)
'DB' 카테고리의 다른 글
| 계층형 질의와 셀프 조인 (0) | 2026.10.08 |
|---|---|
| 윈도우 함수, 순위·집계·LAG/LEAD (0) | 2026.10.08 |
| 서브쿼리 종류와 NOT IN의 NULL 함정 (0) | 2026.10.08 |
| 표준 조인, INNER·OUTER·CROSS JOIN (0) | 2026.10.08 |
| 조인 기초, 등가 조인과 오라클 (+) 표기 (0) | 2026.10.08 |


